ブラウザ上でも動く、超小型な System One Decision モデル bekko-system-one を公開
TypeSafe AI の System One Decision モデル、Jev が、汎用性能が非常に高く、いわゆる classification task で解ける課題なら LLM よりも圧倒的に安価・高速で話題ですね。
そこで今回、小型なモデルだとどれぐらいの性能が出せるのだろうと、System One Decision モデル の bekko-system-one-v0(以下 BS1)シリーズを制作してみました。汎化性能は Jev の方が圧倒的に上ですが、S1MB(System One Mosaic Benchmark)(注:著者作)では、小さなモデルながら、ほかの大きなサイズのモデル並みの結果が得られています。とりわけ、学習しているドメインのタスクでは、なかなかの精度で利用が可能です。
なお対応言語は、英語のみとなっています...。
ブラウザ上で実行可能
本モデル(英語のみ対応)は 17M、68M、400M パラメーターの3つのサイズのモデルを公開しており、とりわけ 17M や 68M の小型モデルは、ブラウザ上にモデルをロードし、CPU での推論も十分な速度で可能です。

注意: なおこのデモは、BS1 モデルで解きやすいタスクを恣意的に選んでいるため、ぱっと見の性能は良さそうですが、Jev のような「幅広いタスクで高性能」なわけではないので、ご注意ください。
また、17M パラメーターというのは、総パラメーター数が約17Mで、そのうち埋め込みを除くパラメーター数は、たったの約4Mです(ここでは Active Parameters - AP と呼びます)。ブラウザ実行用に、token の lookup table だけを INT8 にしたものを ONNX へと変換しており、モデルファイル単体のサイズは、たったの約29MBとなります。
評価ベンチマーク
ブラウザで動いたとして、実際のモデルとしての性能はどんな感じでしょうか。というわけで評価をしてみました。S1MB - System One Mosaic Benchmark という、私作のベンチマークを使っています。このベンチマークは、後述のデータセットのうち、test set のデータを中心に、原則100ケースを抽出した、137個(Noul 59, Choice 57, Score 21)のベンチマークで構成されており、Noul、Choice、Score の3軸で評価しています。
S1MB については、S1MB記事で書いているので、詳細は割愛しますが、総パラメーター数500M以下に絞ると以下のような結果です。BS1 も、超小型としては、かなり健闘しているのではないでしょうか。なお比較のために Jev 1.13 も載せています。
| Model | Avg | Noul | Choice | Score | Total Params | Active Params |
|---|---|---|---|---|---|---|
| Jev 1.13 | 59.59 | 64.63 | 67.22 | 46.92 | — | — |
| bekko-system-one-v0-400m | 50.60 | 51.24 | 61.32 | 39.25 | 395M | 343M |
| bekko-system-one-v0-68m | 40.46 | 42.91 | 51.62 | 26.85 | 68M | 42M |
| bekko-system-one-v0-17m | 27.57 | 31.43 | 35.57 | 15.70 | 17M | 4M |
| von | 16.21 | 20.15 | 23.99 | 4.48 | 395M | 343M |
| laya-typed-decisions | 15.00 | 20.06 | 18.93 | 5.99 | 421M | 370M |
| laya | 13.36 | 20.19 | 16.31 | 3.58 | 421M | 370M |
| laya-multilingual | 9.28 | 14.01 | 13.03 | 0.79 | 322M | 125M |
AvgはNoul・Choice・Scoreの調整済みスコアを等重みで平均した値です。各スコアは高いほど良く、正解率そのものではありません。
しかしながら、S1MB に含まれる「汎化性能を計測する」ベンチマーク(GPT-6-Astra で生成した合成データセット)では、BS1 モデルは圧倒的に性能が悪いです。これは「特定ドメインを学習したデータセットなら、ある程度の性能は出るが、自由な指示や未知のドメインについては弱い」と言えるでしょう。なので、今回公開した BS1 も「汎化性能を持った System One Decision モデルに達していない」ことから version 0 として、-v0 suffix をつけています。
全体評価と同じモデルについて、汎化性能の6ベンチマークに絞った結果です。Avg順に並べています。
| Model | Avg | General Noul | General Choice | General Score |
|---|---|---|---|---|
| Jev 1.13 | 96.27 | 99.00 | 98.68 | 91.14 |
| bekko-system-one-v0-400m | 54.48 | 52.00 | 80.30 | 31.14 |
| von | 43.19 | 41.00 | 65.89 | 22.67 |
| bekko-system-one-v0-68m | 32.48 | 31.00 | 57.52 | 8.90 |
| laya-typed-decisions | 31.82 | 22.00 | 58.80 | 14.67 |
| laya | 26.50 | 9.00 | 54.83 | 15.67 |
| bekko-system-one-v0-17m | 18.96 | 15.00 | 39.11 | 2.76 |
| laya-multilingual | 14.47 | 6.00 | 36.67 | 0.75 |
なお、Jev はドメイン特化性能(特別にそのドメインを学習したわけではないのに、すごいですね)も、汎化性能も、特筆したスコアですね。とりわけ汎化性能のスコアについては、ほぼほぼ満点と言えるでしょう。つまり、汎化性能が高い System One Decision モデルを名乗るには、最低限この汎化性能ベンチマークで、Jev 並みのスコア(つまりほぼ満点)を出せないと、あまり意味がないと思っています。
モデルサイズと推論速度
BS1 モデルで、特筆すべきことはモデルサイズと推論速度です。GPU(RTX 5090)を使ったS1MBの26,269件の評価処理は、17Mで約13.33秒、68Mで約34.04秒、400Mで約132.97秒(約2分13秒)でした。17Mでは、モデルロードと各ベンチマークのデータ読み込みなどを含む計測区間の合計でも約21.38秒です。冒頭のデモのように、ブラウザ上でも現実的に動きます。
なおJevはAPI経由となり、通信待ちなどを含む各ベンチマークの評価時間の合計は約58分37秒でした。APIの応答時間はタイミングによって前後するでしょう。ここで示した値は評価処理の計測値で、純粋なモデル計算だけの時間ではありません。また、17Mの約21.38秒もwarmupなどを除く区間の合算で、コマンド開始から終了までの時間ではありません。
技術アーキテクチャでの取り組み
Bekko System One(以下 BS1)で工夫したのは、複数の選択肢を判定するときに、共通する入力の処理を使い回すことです。その方法の前に、まず一般的な encoder model で、Jev のような処理をする、よくある方法の二つを解説しましょう。
cross encoder
通常の双方向 encoder を使う cross encoder では、以下のように、共通する入力と選択肢を組み合わせて処理します。特殊トークンは模式的な表記です。
[CLS] {state} {instruction} [SEP] {criteria A} [SEP]
[CLS] {state} {instruction} [SEP] {criteria B} [SEP]
[CLS] {state} {instruction} [SEP] {criteria C} [SEP]
先頭の CLS トークンの表現や、トークンの表現を平均したベクトル(mean pooling)を、学習済みの head に渡してスコアを求めます。情報検索の reranker でも広く使われている方式です。
入力と選択肢がお互いを参照できるため、細かな対応関係を捉えられます。しかしながら、state が長いと、同じ文章を選択肢の数だけ処理することになります。前半の表現も後半の選択肢によって変わるため、前半が同じ文字列でも、途中の計算結果をそのまま使い回せないのです。
なお情報検索の reranker では、前半に配置する検索クエリが短いことがほとんどのため、共有による計算量削減の効果が小さく、cross encoder でも良いケースが多いですね。
listwise encoder
それなら、選択肢をまとめて一回で処理しちゃおう、という方法もあります。全候補を連結する listwise 方式では、例えば以下のように入力します。
{state} {instruction} [SEP]
{criteria A} [SEP] {criteria B} [SEP] {criteria C} [SEP]
候補ごとの表現や候補前後の特殊トークンを pooling するなどして、スコアを求めます。共通部分を一度で処理でき、選択肢同士も参照できるのが利点です。
一方、候補が多いと入力全体が長くなります。全トークン間で attention を計算する場合、その計算量は長さの二乗に比例するため、多数の候補をまとめると負担が増えます。cross encoder より常に遅いということではなく、文章の長さや候補数によって向き不向きがあります。
BS1 の方法 - 共有 prefix
BS1 では、state と instruction を一つの共有部分(prefix)として処理し、各層の Key/Value、いわゆる K/V を保存して使い回します。
{state} {instruction} → 各層の共有 K/V
                          ├─ {criteria A} → score A
                          ├─ {criteria B} → score B
                          └─ {criteria C} → score C
普通の cross encoder と何が違うの?と思われるかもしれませんが、ここでは参照できる範囲を変えています。共有 prefix は選択肢を参照せず、各選択肢は共有 prefix と自分自身だけを参照します。これなら、選択肢が変わっても共有部分の計算結果は変わらないため、一度計算した K/V を再利用できます。
LLM の KV cache と同じように K/V を保存しますが、次のトークンを一つずつ生成するわけではありません。共有部分を処理した後、各選択肢を並列に処理し、候補側の表現を mean pooling して head からスコアを求めます。
候補側だけを pooling していますが、候補の文章しか見ていないわけではありません。各候補は各層で共有部分を参照するため、state と instruction を踏まえた表現になっています。一方、共有部分の先頭に置いた CLS トークンは候補を参照できないので、その表現だけでは候補ごとの判定はできません。
これによって、長い state と instruction を選択肢ごとに処理し直す必要がなくなります。ただし、通常の cross encoder と同じ計算を、そのまま高速化したものではありません。通常の cross encoder では、候補に応じて入力側の表現も変わり、その情報を候補側が再び参照できます。BS1 では、この相互のやり取りを制限する代わりに、共有部分の計算を使い回しています。
そのぶん、細かな対応関係を捉える自由度は通常の cross encoder の方が高いと考えられます。ただ、実際の精度差はタスクや学習条件にもよるでしょう。
なお、state と instruction はまとめて双方向に処理しています。state だけを独立してキャッシュしているわけではないため、instruction を変えた場合は共有部分を再計算します。
また、今回は、criteria 同士が参照できるような attention は含めてません。本来、例えば Choice のようなケースですと、他の criteria を参照した上で回答した方が精度がありそうですが、短時間で試しただけでは、精度が上がる学習ができなかったです。なおこれは無理だ、と言っているわけではなく、私が試した方法でうまくいかなかっただけの可能性も十分あるでしょう。
大元の base model
大元の base model としては、ModernBERT アーキテクチャの英語高性能モデルである Ettin-encoder を、さらに教師 reranker モデルを用い cross encoder として学習した Ettin-reranker を利用しています。
ModernBERT などの MLM、いわゆる pretrained model の状態では、検索クエリとドキュメントの関連度を直接スコア化するようには学習していません。情報検索向けデータを学習した Dense Embedding モデルや、cross encoder モデルでは、文章とドキュメントの関連性を理解しているため、今回はすでにそれらを学習済みの Ettin-reranker を使っています。小型ながら、英語 rerank 性能は非常に高いです。今回の BS1 では、Ettin-reranker を base model として用い、追加学習を行いました。
以下は Ettin-encoder、Ettin-reranker を base model とし、各データセットに上限を適用した学習データの全量を、同じ条件で学習させた対照実験の結果です。68Mではreranker初期化が総合CE・各型のaccuracyで良く、17Mでは総合CEは僅差で、Noul・Choiceはreranker、Scoreはencoderが良い結果でした。
| サイズ | 初期化モデル | 総合CE ↓ | Noul accuracy ↑ | Choice accuracy ↑ | Score accuracy ↑ |
|---|---|---|---|---|---|
| 17M | Ettin-encoder | 0.8694 | 68.71% | 60.14% | 56.57% |
| 17M | Ettin-reranker | 0.8713 | 69.88% | 60.77% | 53.88% |
| 68M | Ettin-encoder | 0.7625 | 72.87% | 69.78% | 58.16% |
| 68M | Ettin-reranker | 0.7180 | 77.01% | 71.13% | 61.34% |
CEは小さいほど良く、accuracyは大きいほど良い指標です。データセットごとに集計し、二つの入力順序の結果を平均しています。前掲の調整済みスコアとは指標が異なります。各条件1 seedでの比較です。
データセット
データセットでは hotchpotch/bekko-system-one-dataset-v0 を利用しています。このデータセットは、既存の NLP や情報検索関連のデータセットを、Noul、Choice、Score の3形式として学習しやすいように変換した 153 個の学習データセットで、training set は約659万ケースとなっています。一部は合成データセットも追加してあります。なお、このデータセットの test set は S1MB のベンチマークにも転用しているので、同じドメインの training set で学習した BS1 は S1MB の一部ベンチマークのスコアが上がりやすくなっています。
BS1 では、このデータセットを用いて学習を行いました。学習には RTX 5090 を用い、17M の学習では、たった2時間で学習を終えました。なお 68M では5.5時間、400M では約25時間でした。
学習のハイパーパラメーター
学習のハイパーパラメーターやデータセットの件数などは、細かくは解説しませんが、bekko-embedding 論文(私作の、超小型マルチリンガル dense retrieval model の論文です)で書かれている知見を主に、いくつかパラメーターを試し、その範囲で良い結果が得られた値を使っています。
| 項目 | 17M | 68M | 400M |
|---|---|---|---|
| Optimizer | AdamW | AdamW | AdamW |
| Batch size | 512 | 512 | 512 |
| Encoder learning rate | 1e-4 | 3e-5 | 1e-5 |
| Head learning rate | 5e-4 | 2e-4 | 2e-4 |
| Weight decay | 0.01 | 0.01 | 0.01 |
| Warmup ratio | 10% | 10% | 10% |
| Learning-rate schedule | Cosine | Cosine | Cosine |
| Query / candidate上限 | 4,096 / 2,048 tokens | 4,096 / 2,048 tokens | 4,096 / 2,048 tokens |
学習用の実装も公開しているので、この実装を使うことで、同様のモデルを学習可能です。興味がある方は、ご利用ください。
超小型の System One Decision モデルは実現可能なのか?
将来は、S1MB の汎化性能ベンチマークでも Jev 並みのスコアに達する、アクティブなパラメーターサイズが100M以下といった、超小型なモデルも可能である、と思っています。それを達成するための、最も重要なことは、学習に必要な高品質な合成データセットです。
TypeSafe AI CEO の Diogo Almeida 氏も「100% of our data is synthetic (but not the type of crap that is just spit out from an LLM obviously)」と言っているように、Noul、Choice、Score で、ありとあらゆる質問と適切なスコアの合成データセットが用意できれば、超小型モデルも実現可能だと思っています。どうしても「モデルアーキテクチャ」に目線が行きがちですが、高品質で齟齬がない多様な合成データセットをどのように作り、それをどのように学習するか、が肝心でしょう。
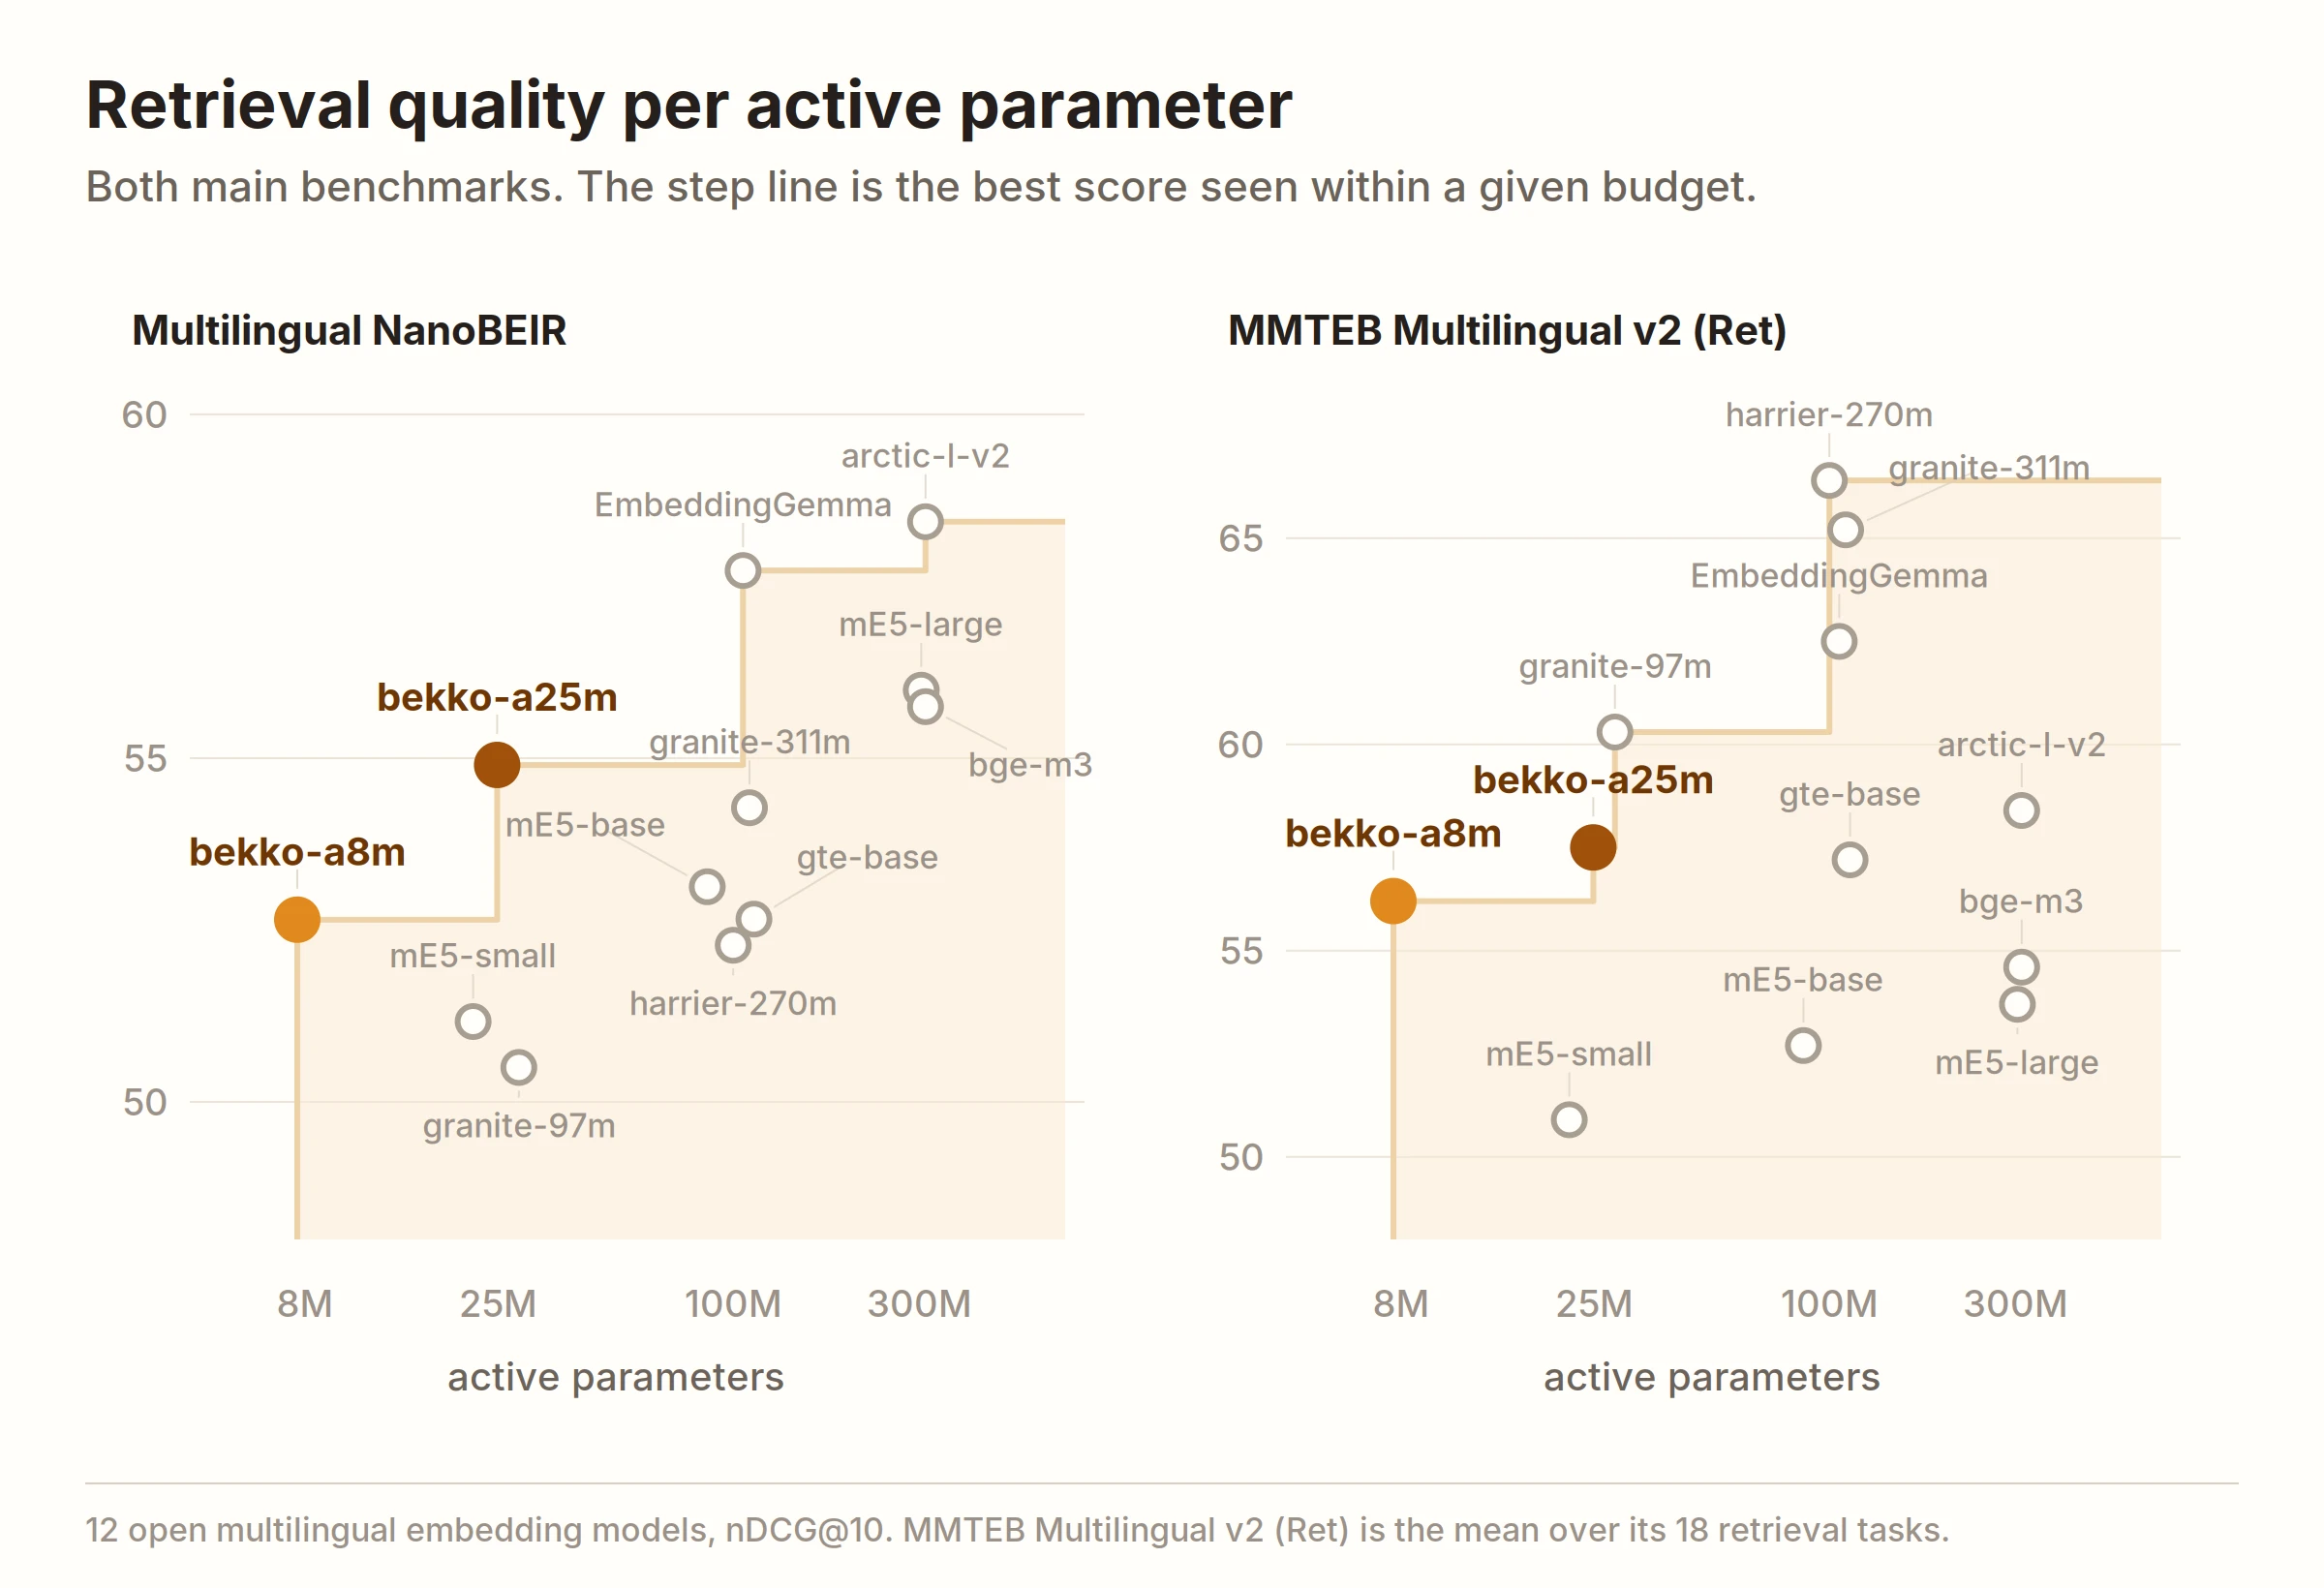
実際に、私作のマルチリンガル情報検索モデルである bekko-embedding シリーズでは、10億以上のデータ(うち1.6億件が合成データセット)を、巨大バッチで学習させることにより、アクティブパラメーターサイズが 8M、25M という超小型サイズのモデルで数倍〜数十倍の情報検索モデルに匹敵する情報検索モデルが作れています。
続いての重要なことは、強力な base model の登場です。実用的なテキスト生成能力を持つ LLM(decoder)を超小型にするのは難しいため、文字列生成にこだわらなければ、もっと小型で性能が良い base model が作れるでしょう。ModernBERT はその例だと思いますが、現状のさらに発展し続けている LLM のモデルアーキテクチャを使い、さらに小型モデルでより良いアーキテクチャと、大量の多様なデータを学習させた base model があれば、その継続タスクの学習に効いてくるでしょう。ただし、合成データセットの方が重要度は非常に高いとは思っています。
終わりに
TypeSafe AI の System One Decision モデル、Jev の登場により、汎化性能が高い Classification model の有益性が証明されました。TypeSafe AI の素晴らしい点は、中途半端な汎化性能で出すのでなく、フロンティア LLM に並ぶ性能の超汎化性能を持つモデルを作り上げ、出したことでしょう。
Classification で解決できる課題は、思った以上に広いです。BERT 以降、分類やスコア付けなどの NLP タスクでは Transformer encoder が広く使われてきました。
本記事では、学習したタスクなら、ブラウザ上でも動くほど小さなモデルである程度の精度を出せる、bekko-system-one-v0 を作ったお話でした。学習済みのタスクで小型モデルを試したり、独自データで追加学習したりするための出発点として、モデル・データセット・学習コードを公開しています。
幅広い未知のタスクへの対応は、今後の課題です。前項で述べたとおり、大量の良質なデータセットや、小型モデルアーキテクチャの進化により、十分な汎化性能を持った System One Decision モデルは、きっと開発されるはずです。
この bekko-system-one-v0 が、何らかの価値につながれば幸いです。
参考URL
bekko-system-one
- bekko-system-one collection
- bekko-system-one-v0-17m
- bekko-system-one-v0-68m
- bekko-system-one-v0-400m
- ブラウザデモ
- 学習・推論コード
- 学習データセット
S1MB
base model・関連モデル・資料
- TypeSafe AI — System One / Jev
- TypeSafe AI — モデル一覧
- Diogo Almeida 氏の合成データについての投稿
- Laya:コード / モデル
- ModernBERT-base
- Ettin:Seq vs Seq 論文
- Ettin-reranker-17m-v1
- Ettin-reranker-68m-v1
- Ettin-reranker-400m-v1
- bekko-embedding-v1-a8m
- bekko-embedding-v1-a25m
- Bekko Embedding 論文
- Sentence Transformers — Cross-Encoders