自作フィードリーダーを作った
みんな自作 FeedReader 作っているなぁ、でも今使っている Inoreader (今は亡き、安価な年額19.99USDの starter planを使い続けている) でいいや、と思っていたのだが、結局細かいあれこれをブラウザ拡張の Tampermonkey などでちまちま修正していて、ちょっと魔がさしたので作ってみた。
30行ぐらい雑な仕様を書いて Opus 5.5 氏に実装していただいたら、ほぼ満足のものが一発で出来上がり、あとは挙動の微調整を行ったら普通に満足なものができてしまった。Claude Opus 5.5 の実装・実現能力の高さはびっくりするね。
特にソースコードは公開していない(なぜなら以下をコピペで同じようなものはすぐ作れるから・・・)ので、俺俺フィードリーダー作ったよ、という自己満足記事です。
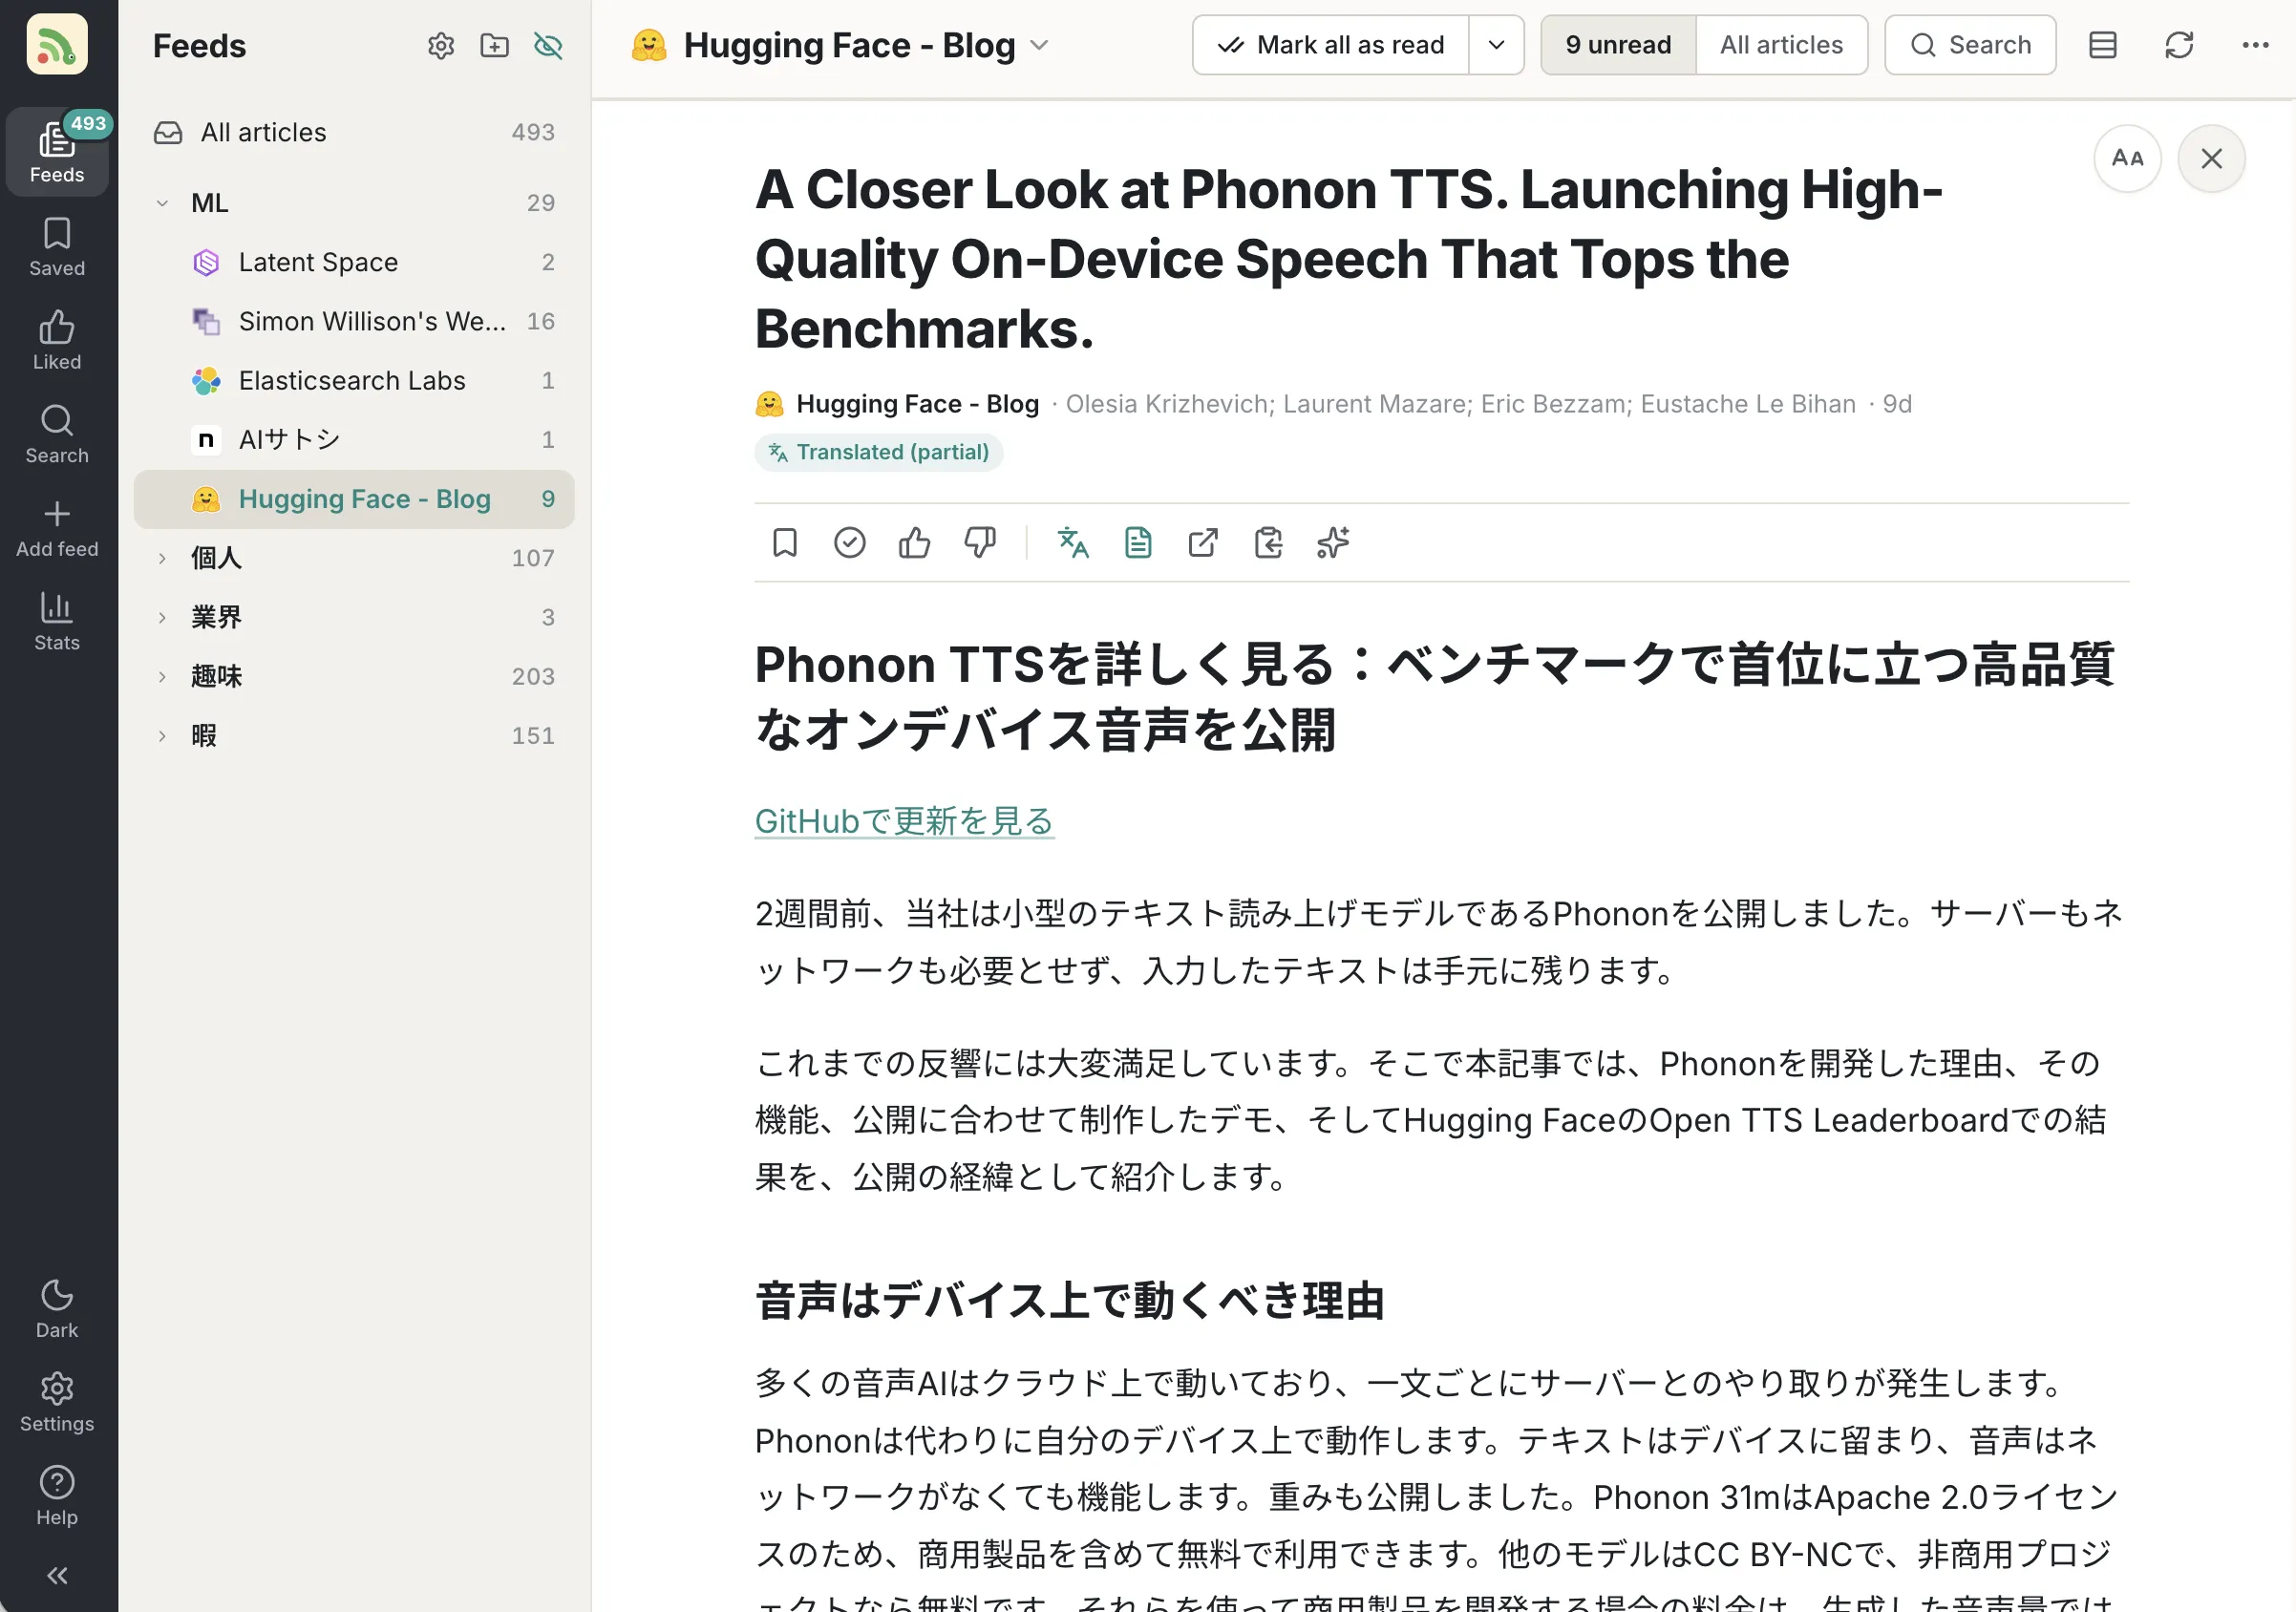
以下は機能のご紹介。これらの機能を、ほぼ最初の指示からの40分で実装し切った Opus 5.5 はすごいなぁ。
全文抽出機能
- フィードでは「続きを読む…」程度の要約しか配信していなくても、元記事のページから本文を取ってきてリーダーで読める。
- タイトルや本文の抽出方式は go-trafilatura、Jina Reader、CSS/XPath セレクタの3つ。同じ記事で3方式を試して、文字数と処理時間を比べてから選べる。
- CSS/XPath セレクタでの抽出は、LLM が直近複数の記事を用いて推察し、勝手に自動抽出できるセレクタの定義まで行う
- 「全文取得して、PR記事は除外」「3時間おきに更新、翻訳はしない」のような指示を、AI エージェントが構造化された設定に変換する。AI を使うのは設定するときだけで、そのあとは保存した設定どおりに決定的に動く。
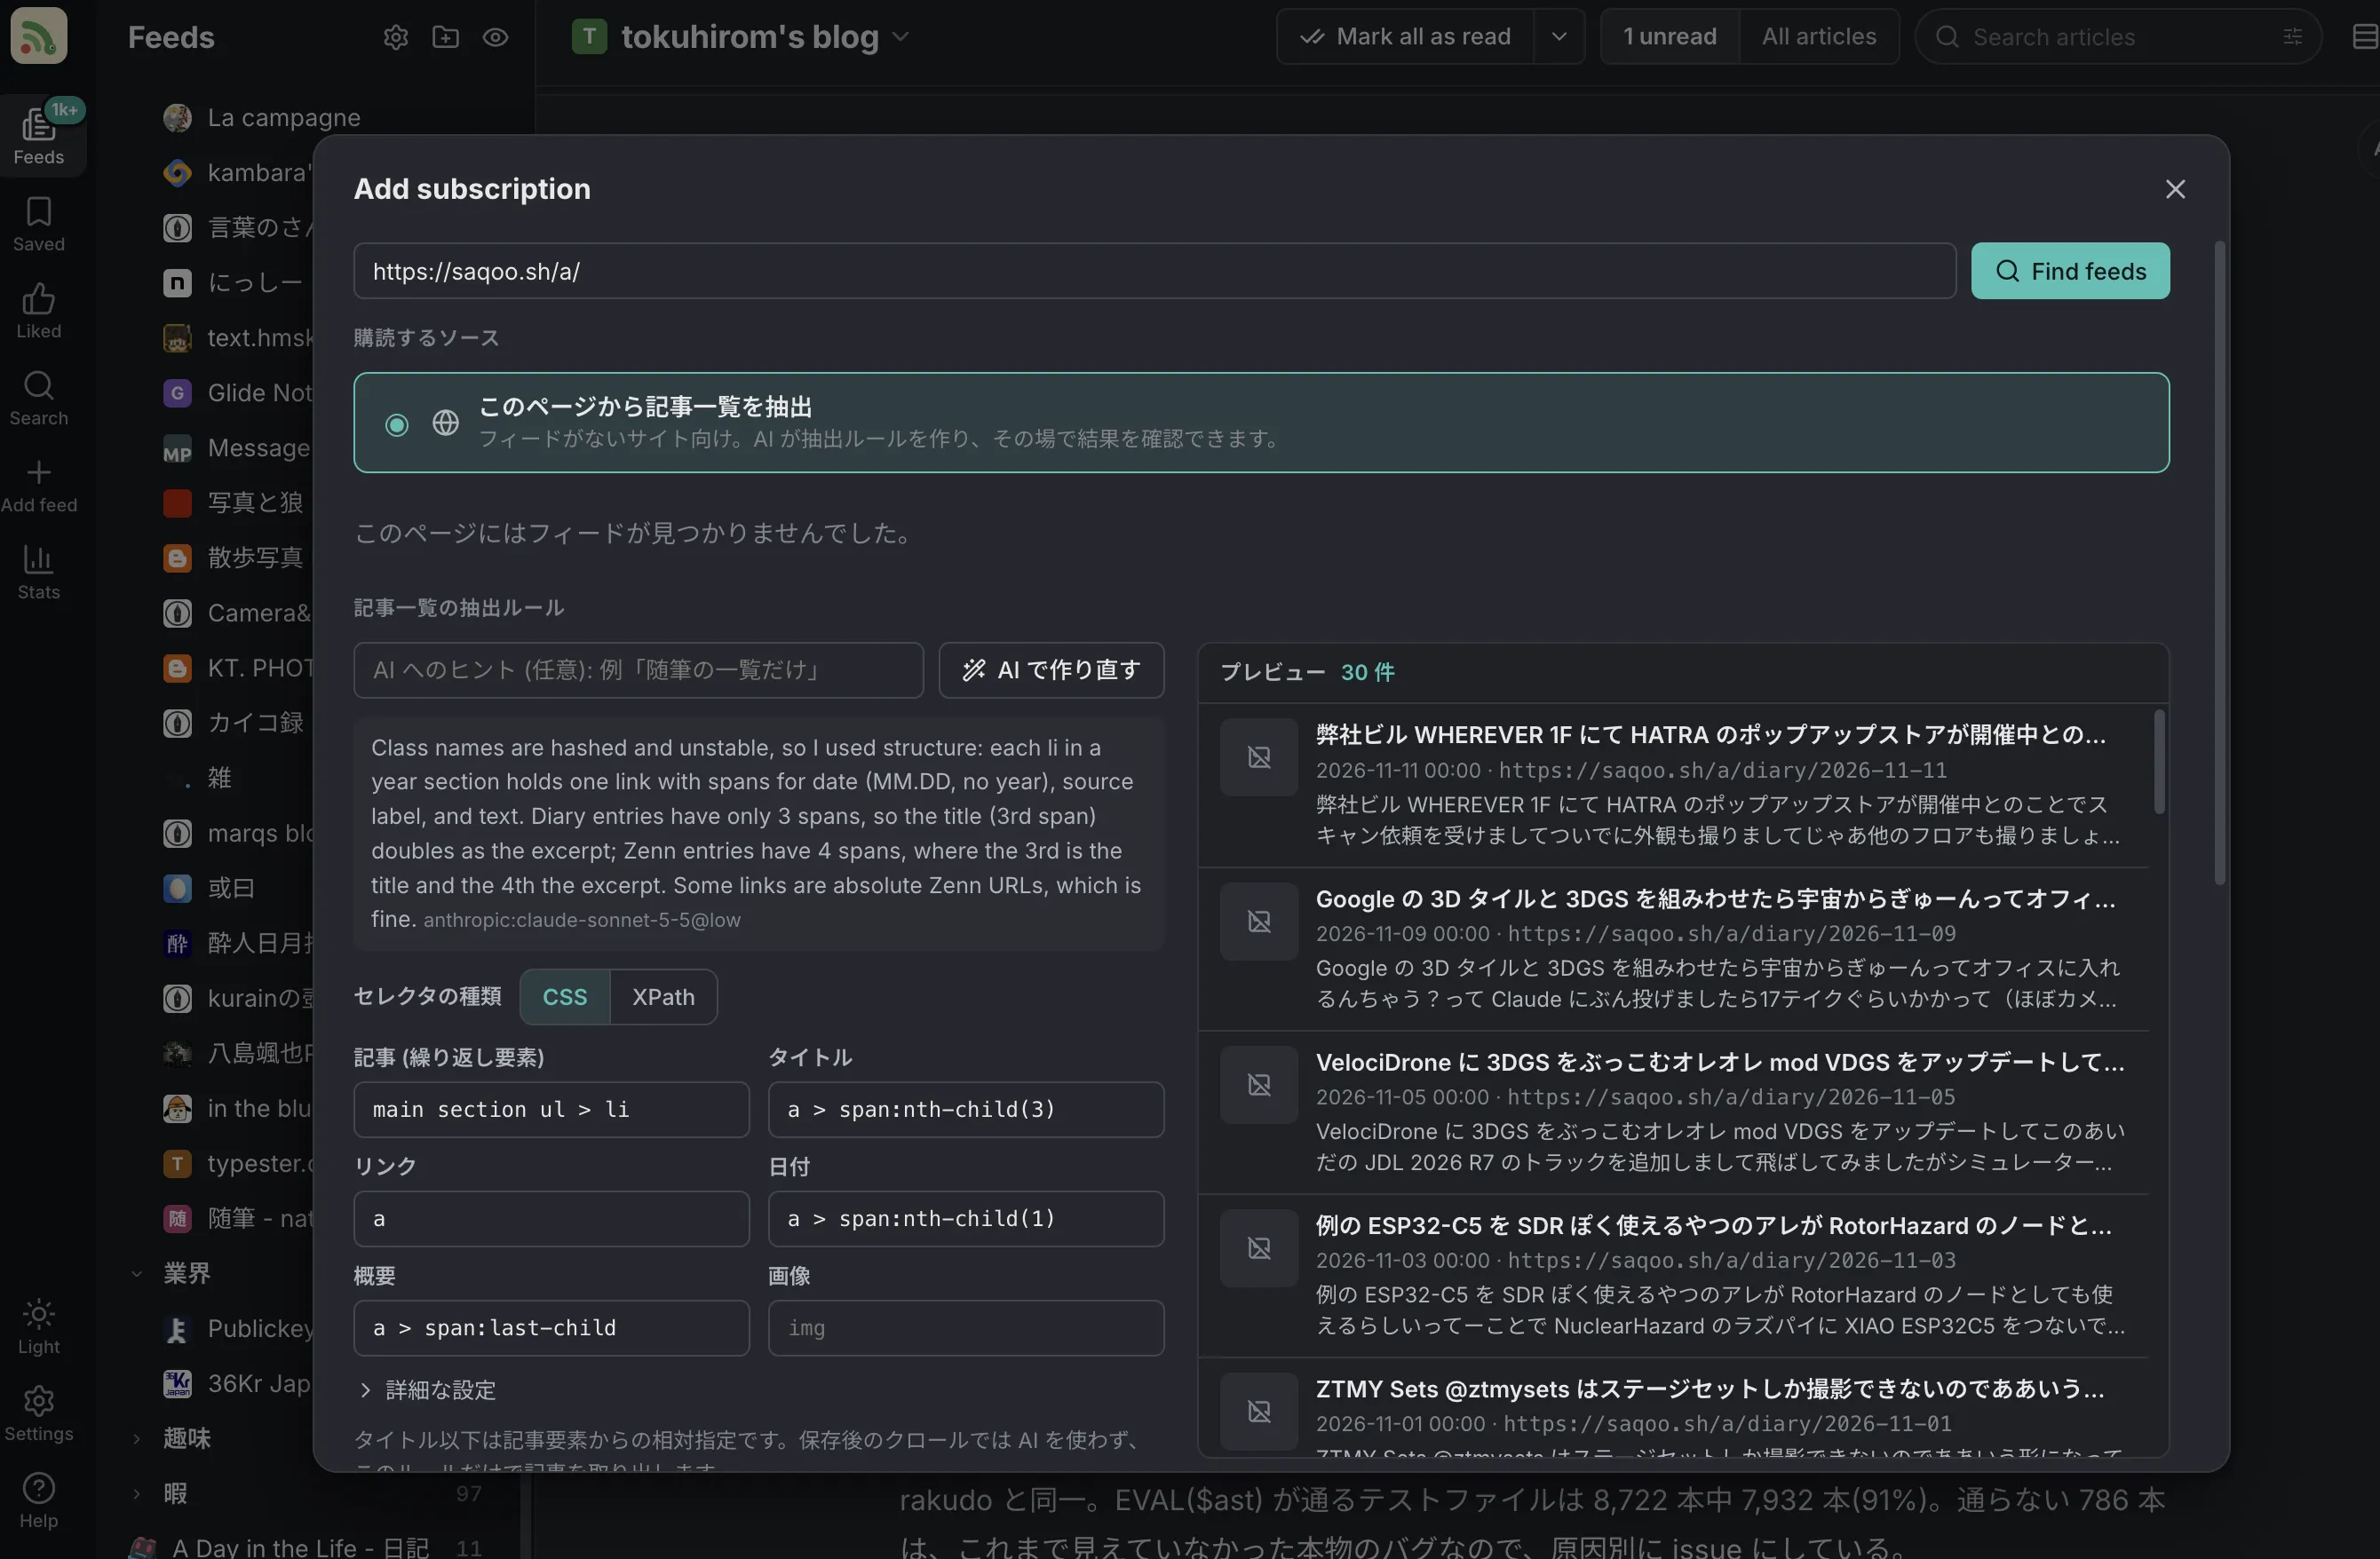
フィード配信していないサイトの対応
- url を入れると、先ほどの全文抽出と同様、勝手に AI が記事っぽいコンテンツを抽出し、css / xpath セレクタで作成する。
- AI を使うのは設定するときだけ。その後のクロールは保存したセレクタを使うだけで LLM を呼ばず、決定的に動く(同じページからは毎回同じ結果が出る)。そのぶん速くて安くもある。
- 雑にフィード配信していないサイトも対応できて便利。
- このスクショだけ黒いのは、dark mode で見ていた時だから…
メールマガジンもフィードとして読める
- Gmail からの転送を Cloudflare Email Worker と R2 で受けて、送信者ごとに自動でフィードを作る。
- トラッキングピクセルやレイアウト用テーブルを取り除き、Web 版の URL に正規化する。
- 有料 Substack のように、メールでしか全文が届かないものに対応できる。便利。
- なお、別にメルマガじゃなくても、なんでも feed にして読める

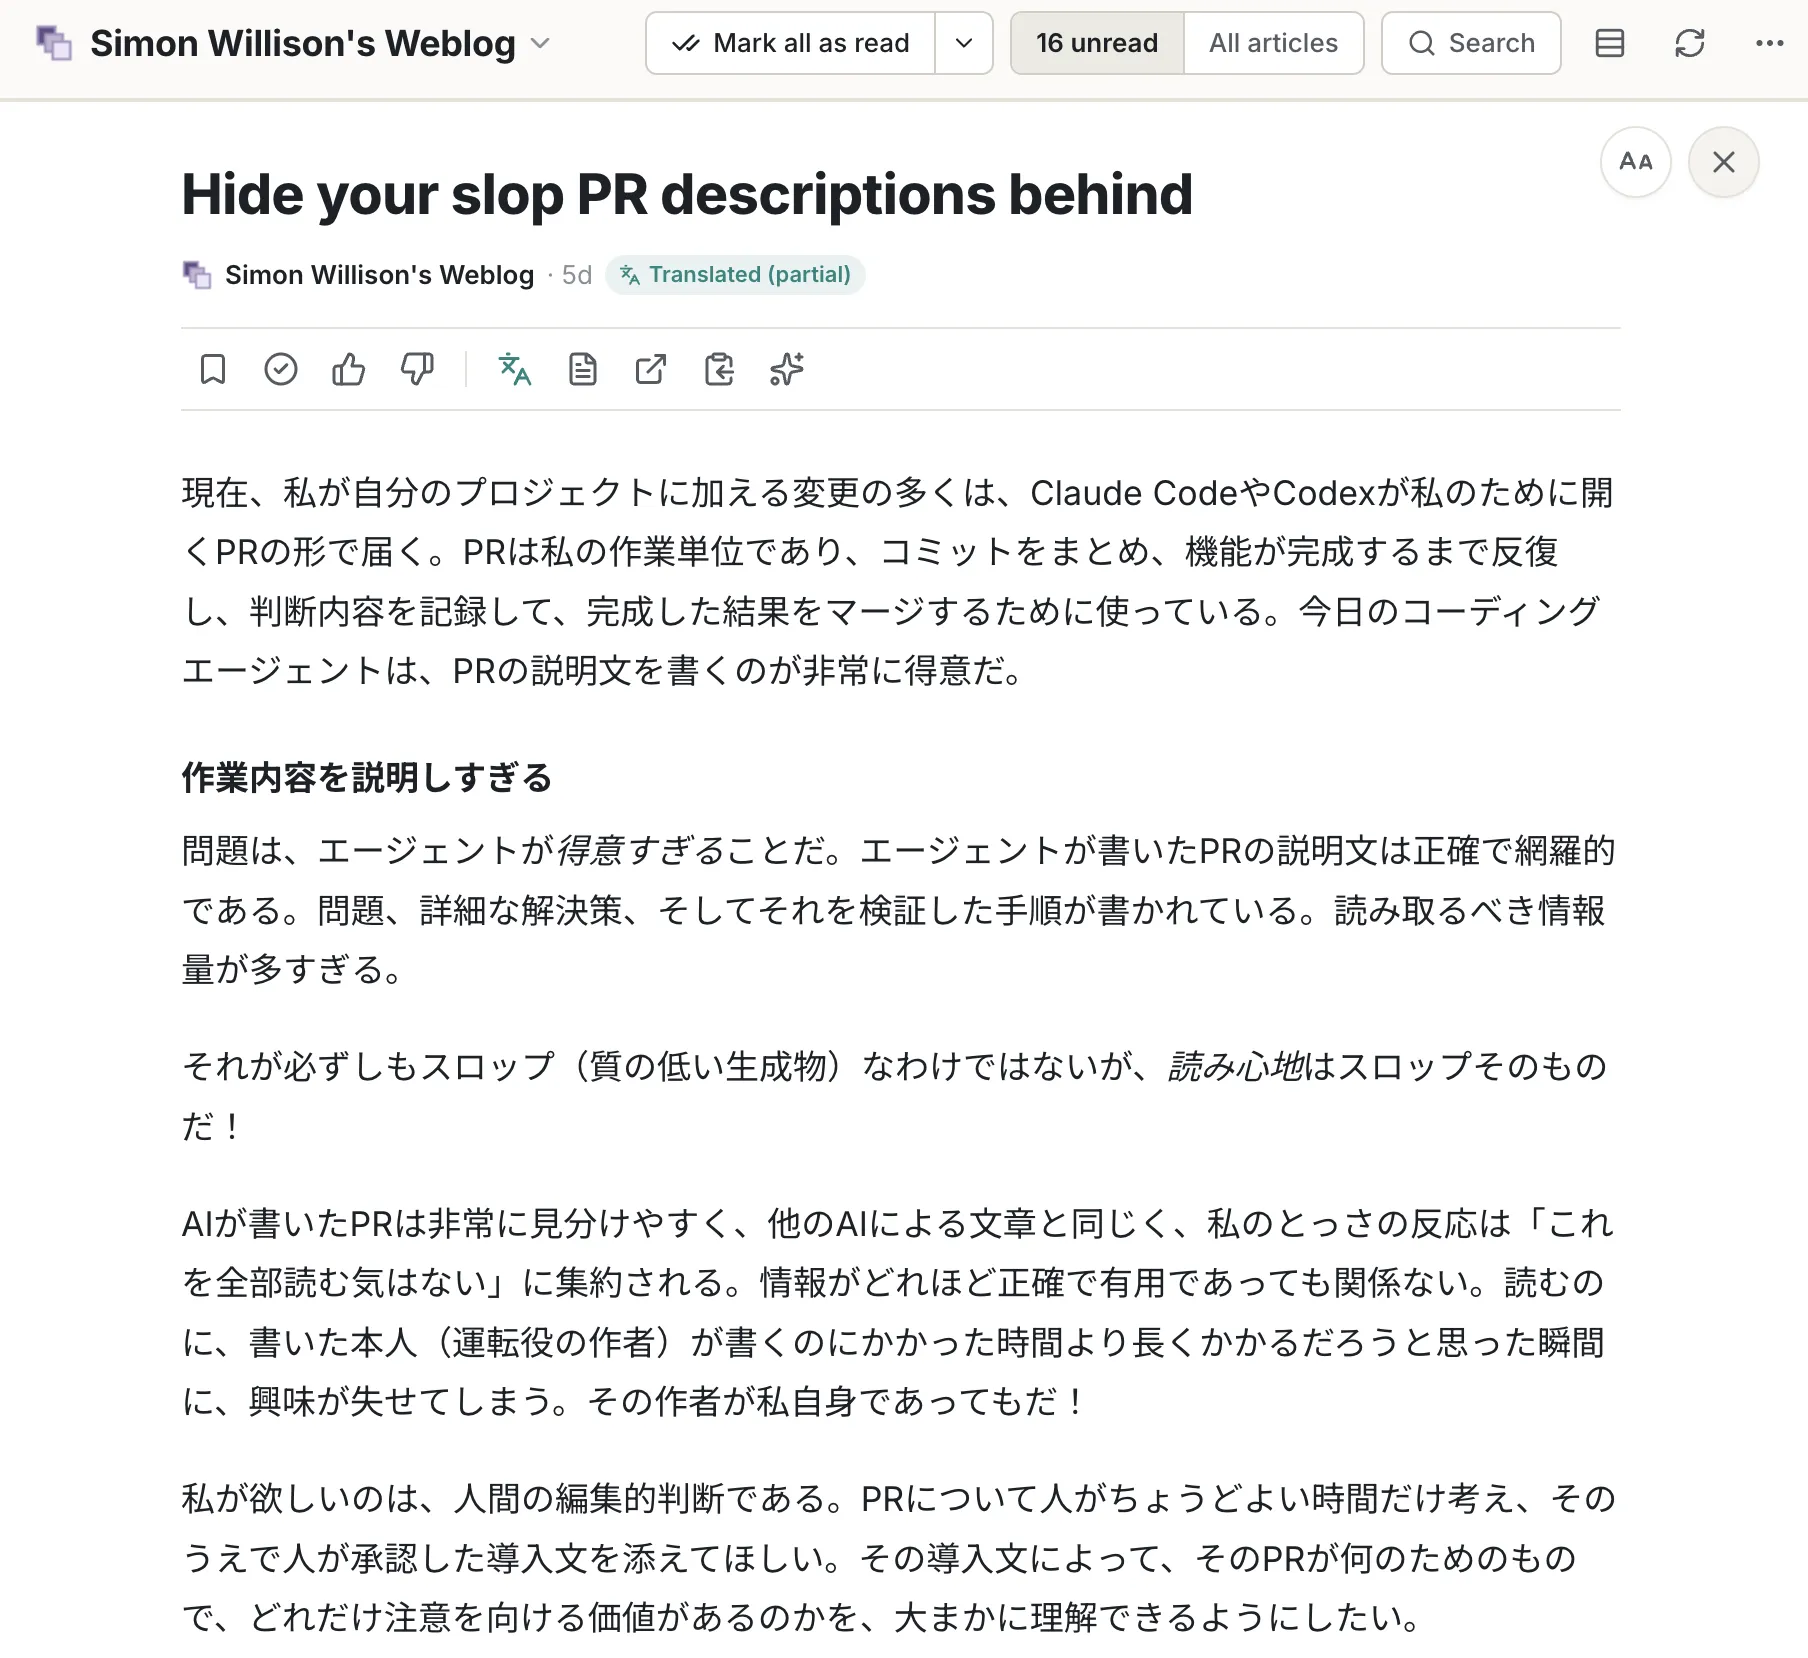
英語記事を自動で日本語に翻訳して見れる
- スクレイピングが済んだタイミングで、langdetect して、日本語以外なら LLM で本文を翻訳する。コード・画像・リンクは翻訳させずに元のまま戻すので、記事の構造が崩れない。
- 翻訳が終わるまで記事を一覧に出さないため、「先に英語版が見えてしまう」ことがない。
- 翻訳で最初から読めて便利。もちろん原文も読める。
- なお Claude にしろ OpenAI にしろ、サブスク 100 USD 以上のプランは、API トークンも100 USD 以上がついてくるので、LLM を叩いても実質無料。便利。
セマンティック・ハイブリット検索
- 全記事を自作のマルチリンガル埋め込みモデル bekko-embedding-v1-a8mでベクトル化し、SQLite + sqlite-vec に保存している。なお CPU でベクトルは作っている。作ってよかった、超小型高性能モデル。
- FTS5 trigram のキーワード検索とベクトル検索を RRF で混ぜるハイブリッド検索なので、言葉が一致しない記事でも意味が近ければ見つかる。
- 埋め込みは 384 dims -> 256 dims に削減して使っている。そこまで性能は不要なので、軽量に。
- クエリの埋め込みは、スクレイピング時には Go で、Webでは transformers.js (ONNX)で同じモデルを使っている。
- しきい値(
sem_min0.40 など)は実際のコーパスで測って決めている。
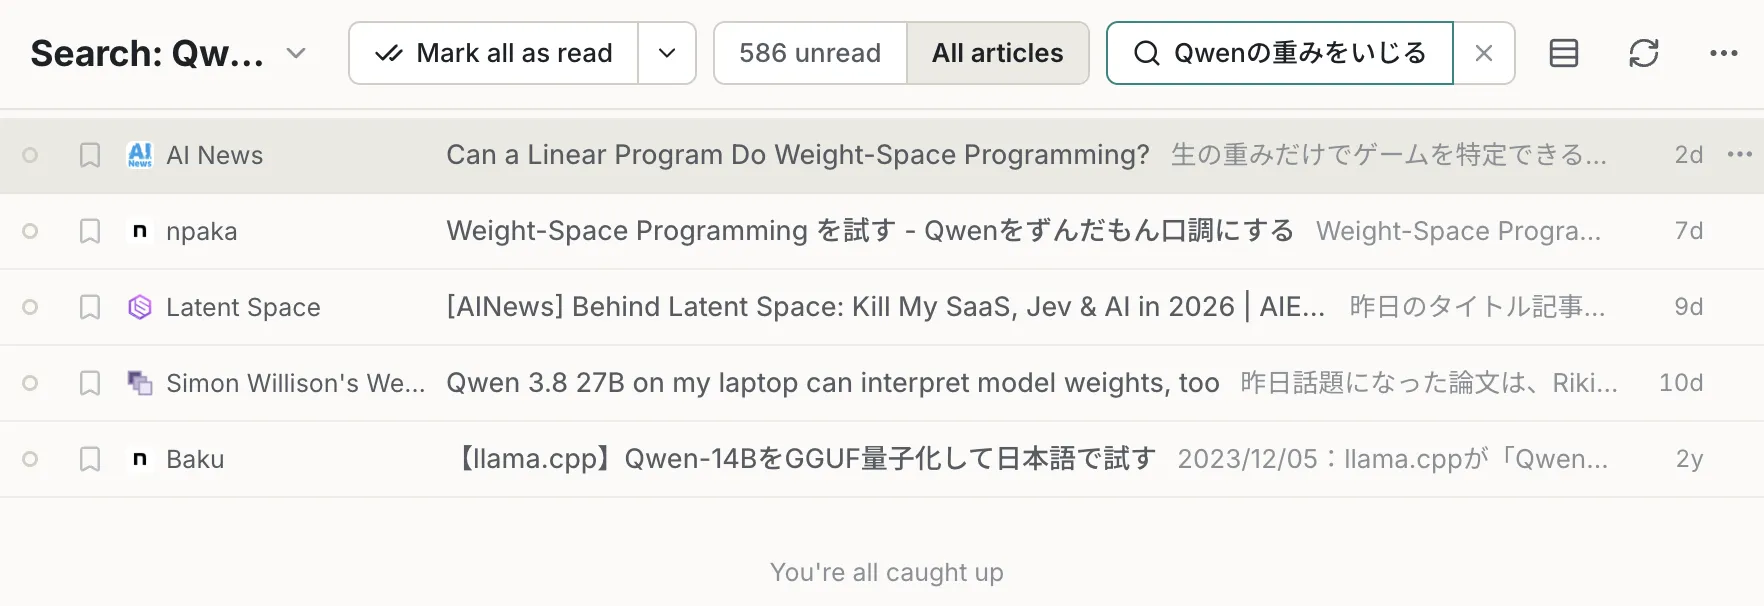
類似記事を出せる
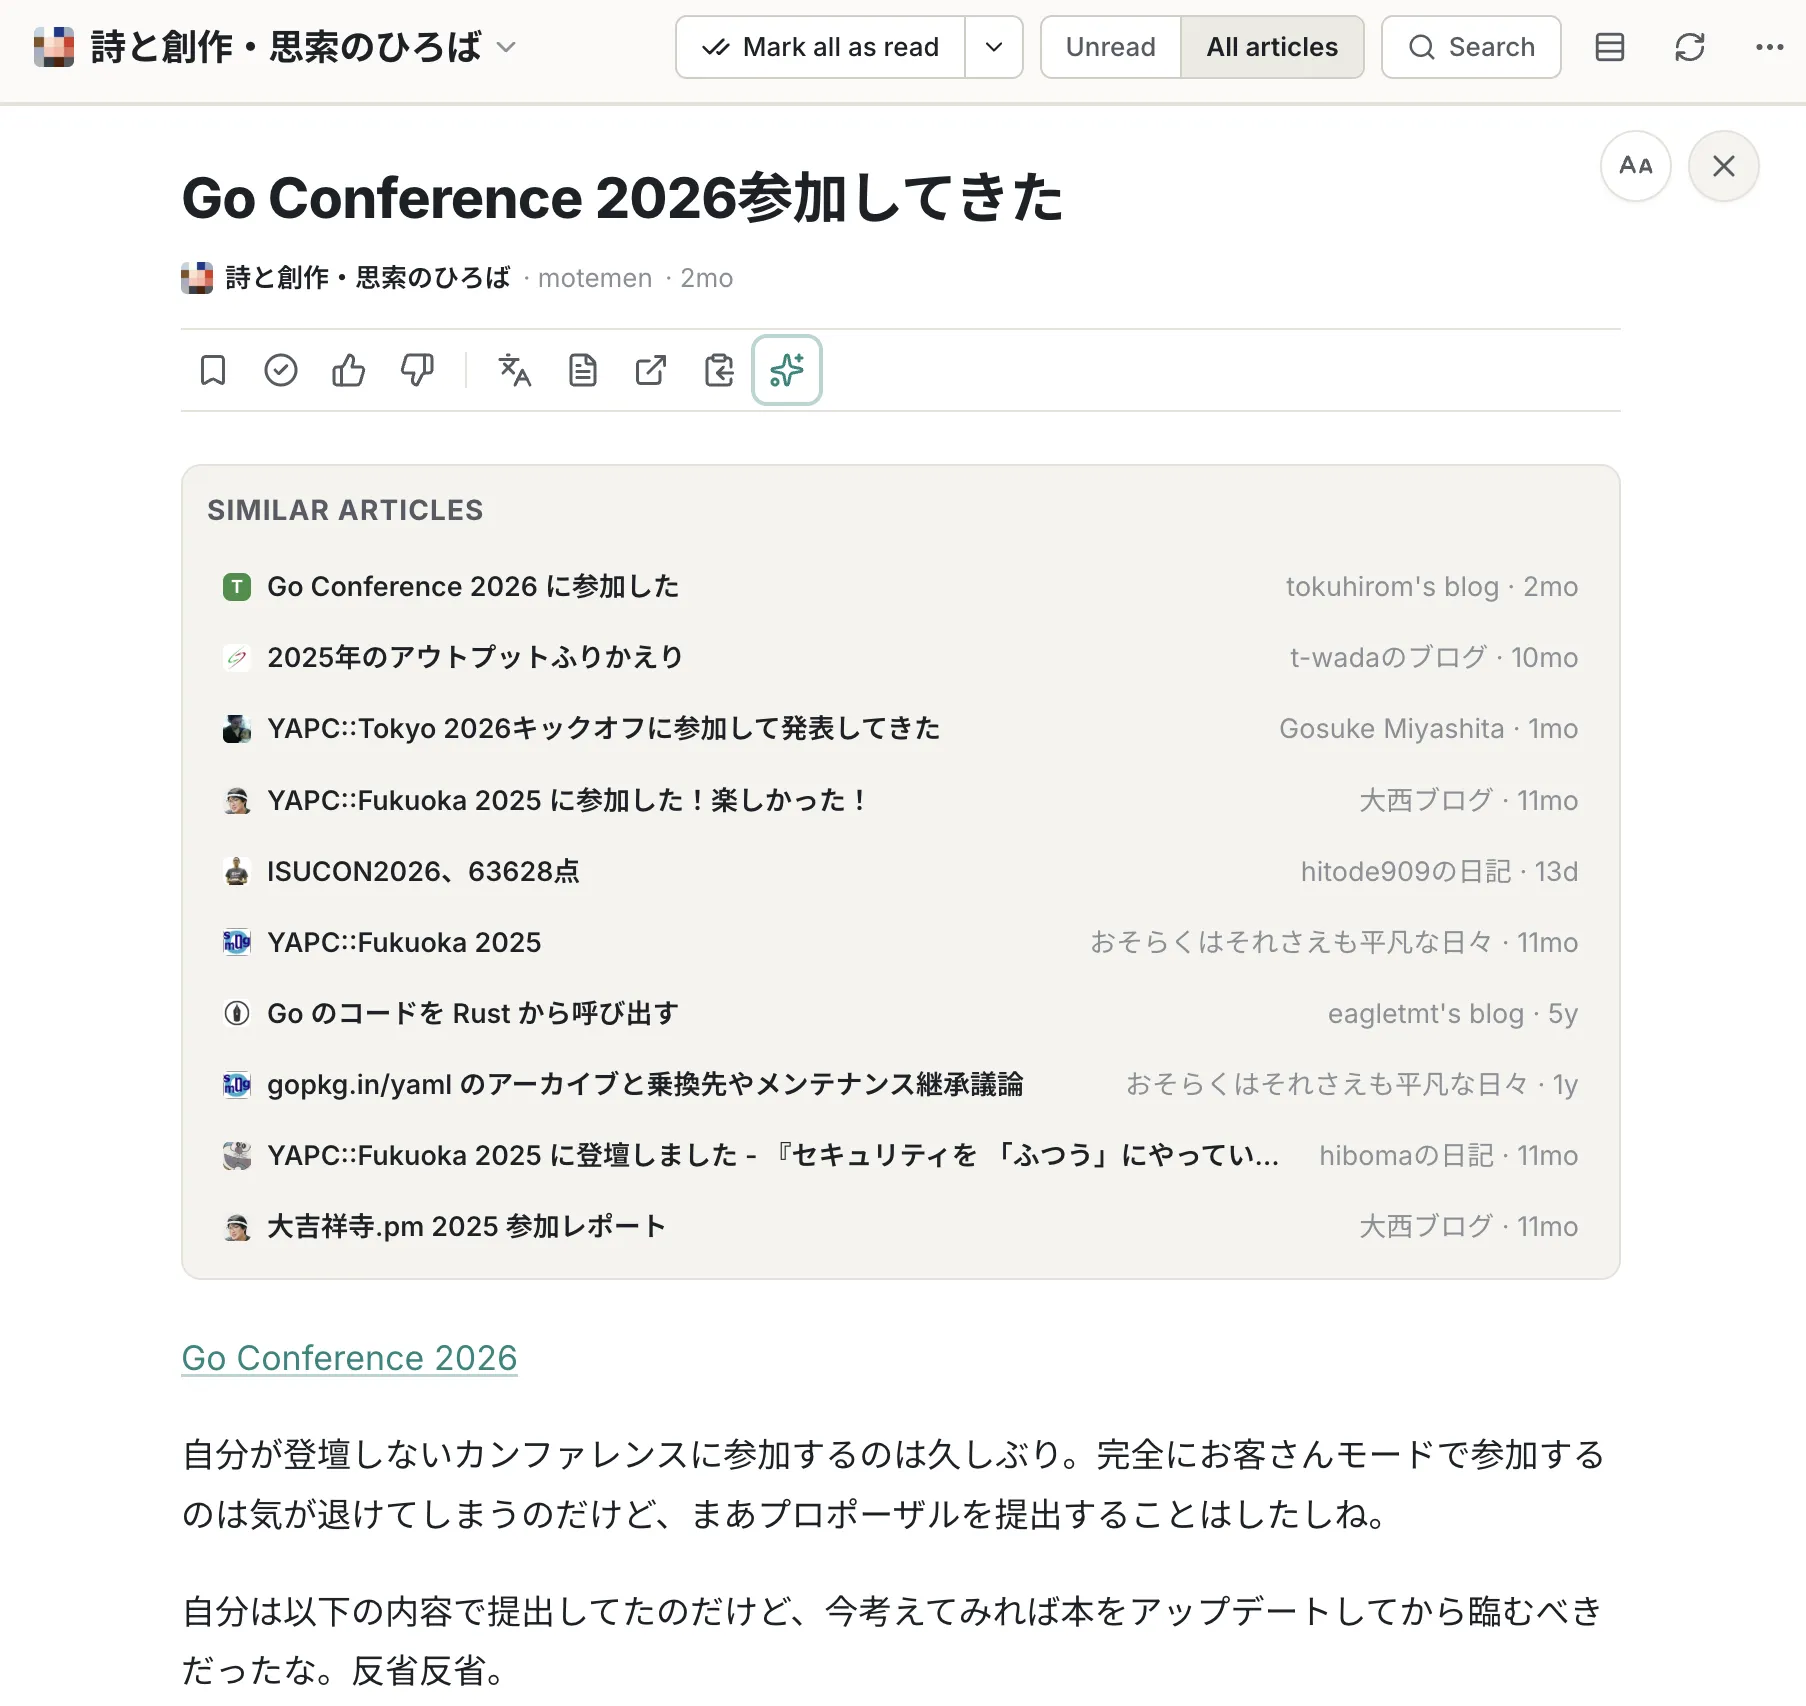
- 埋め込みを使って、読んでいる記事に近い記事をすぐ閲覧できる。
- 同じ話題は1件にまとめたり。
好みの推薦に向けたデータの蓄積
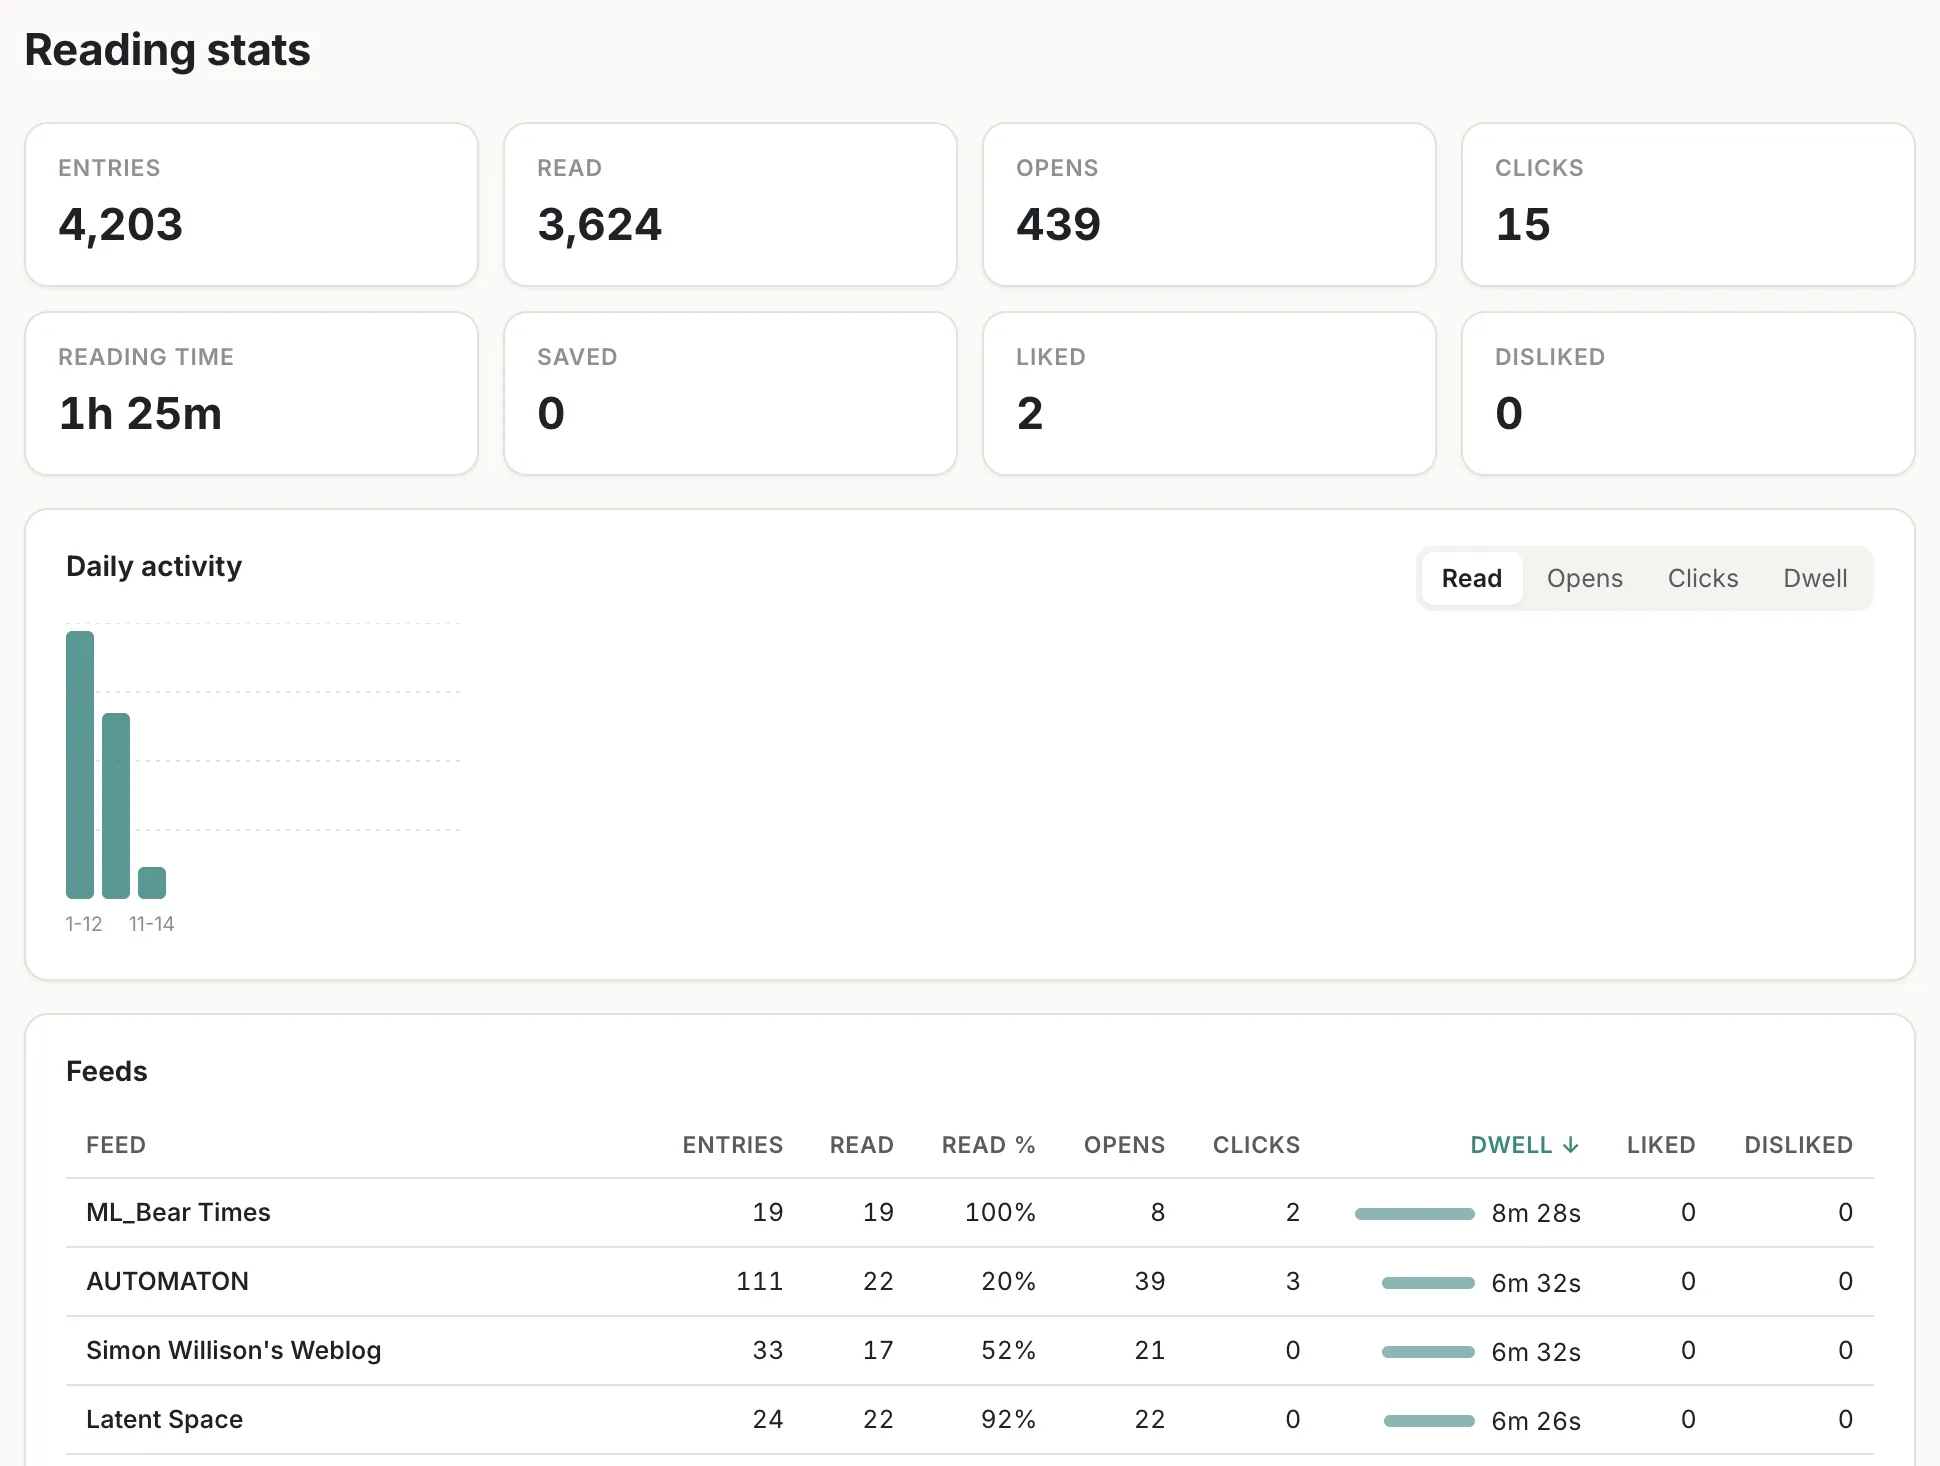
- 開封、実際に読んでいた時間(フォーカス中かつ操作が60秒以内の時間だけ)、リンクのクリック、いいね/よくないね、を記録している。
フィードリーダーとしての UX
- 隣の記事の本文と最初の画像を先読みするので、記事を移ったときに本文や画像がすぐ表示される。
- 先読みは人により好みがあるけど、この辺もすぐに実装できるのも自作ならでは
- 状態がすべて URL に入っているので、リロードや戻る/進むで同じ画面に戻れる。
- UI は Inoreader のようにして、としたら本当にほぼママになってしまった…
- (自分向けだから良いと思っているが)これをもし一般公開するとしたら、リスペクトというよりパクリUI…
実装的な話
- Web(Next.js)とクローラ・Worker(Go)は SQLite だけ共有。外部へのネットワーク通信は Go 側にに集めてあり、責任の分担がはっきりしている。
- クロールは行儀よく動く。
- User-Agent で正直に名乗り、robots.txt は RFC 9309 どおりに守る。
- 同じホストへの同時接続は1本だけにし、更新間隔は記事の公開ペースから自動で決める。
- 条件付き GET、
Retry-After、バックオフにも対応している。