多言語 Static Embedding モデル 'bekko-static-embedding-v1' を公開
多言語の Static Embedding モデル、bekko-static-embedding-v1 を公開しました。Static Embedding の中では情報検索性能で SoTA で、多言語検索ではほかの多言語 Static Embedding を約11ポイント、英語検索でも英語専用の Static Embedding を約2ポイント上回ります。
Static Embedding は Transformer を使っておらず、トークンごとに決まったベクトルを持ち、文章のベクトルはその平均を取るだけです。GPU も不要で、multilingual-e5-small などのモデルと比べて CPU で100〜400倍高速に動かせます。
bekko-static-embedding-v1 では独自に学習した20万語彙の tokenizer を使い、40言語、約8.1億組のテキストペアを16,384のバッチサイズで対照学習しました。
Transformer モデルにもタスクによっては競争力がある性能です。MMTEB の検索タスクでは、12層の Transformer モデルである multilingual-e5-small との差が約1ポイントでした。
性能比較
他の Static Embedding との比較
bekko-static-embedding-v1 は、多言語検索と英語検索のどちらでも、比較した公開 Static Embedding をすべて上回りました。
- 多言語検索:MNanoBEIR(14言語×13タスク、nDCG@10 × 100)は43.76で、static-similarity-mrl-multilingual-v1(32.29)と potion-multilingual-128M(32.23)を約11ポイント上回りました。
- 英語検索:NanoBEIR-en(13タスク)は53.71で、英語専用の stable-static-embedding-fast-retrieval-mrl-en-v2(以下 SST-v2、51.57)と static-retrieval-mrl-en-v1(50.35)を上回り、512次元に切り詰めても(52.82)両モデルより高いスコアです。
- MMTEB:131タスクの平均は50.18で、2つの多言語 Static Embedding より約3ポイント高く、Retrieval カテゴリでは8.75ポイントと12.10ポイントの差がつきました。
- マトリョーシカ次元:512次元に切り詰めても、検索スコア平均の低下は約0.9ポイントです。
| Static Embedding | 言語 | dims | NanoBEIR-en | MNanoBEIR | MMTEB Retrieval | MMTEB 平均 |
|---|---|---|---|---|---|---|
| bekko-static-embedding-v1 | 多言語 | 1024 | 53.71 | 43.76 | 49.96 | 50.18 |
| static-similarity-mrl-multilingual-v1 | 多言語 | 1024 | 43.51 | 32.29 | 41.21 | 47.24 |
| potion-multilingual-128M | 多言語 | 256 | 37.07 | 32.23 | 37.86 | 47.23 |
| static-retrieval-mrl-en-v1 | 英語 | 1024 | 50.35 | 未集計 | 未集計 | 未集計 |
| SST-v2 | 英語 | 512 | 51.57 | 未集計 | 未集計 | 未集計 |
表1:既存の Static Embedding との比較。 NanoBEIR-en は英語検索13タスク、MNanoBEIR は14言語の検索182タスク、MMTEB は分類なども含む131タスクの平均です。 検索列は上位10件の順位と関連度を測る nDCG@10 × 100、MMTEB は各タスクの主指標を100倍した値です。
文脈ありモデルとの比較
Transformer の層をまったく持たないモデルは、Transformer のエンコーダにどこまで近づけるのでしょうか。 比較対象には、小型の多言語検索モデルとしてよく使われる multilingual-e5-small(12層、アクティブパラメータ2,160万)を選びました。
| モデル | Transformer 層 | アクティブパラメータ | NanoBEIR-en | MNanoBEIR | MMTEB Retrieval | MMTEB 平均 |
|---|---|---|---|---|---|---|
| bekko-static-embedding-v1 | 0 | 0 | 53.71 | 43.76 | 49.96 | 50.18 |
| multilingual-e5-small | 12 | 21.6M | 58.37 | 51.17 | 50.9 | 56.4 |
| bekko-embedding-v1-a8m | 4 | 7.7M | 60.34 | 52.65 | 56.2 | 56.7 |
表2:文脈ありモデルとの比較。 NanoBEIR-en と MNanoBEIR は HAKARI-Bench の nDCG@10 × 100 です。 multilingual-e5-small と bekko-embedding-v1-a8m の MMTEB は、同じ131タスクと集計方法による bekko-embedding-v1-a8m のモデルカードの値です。 アクティブパラメータはトークン埋め込み表を除いた数です。
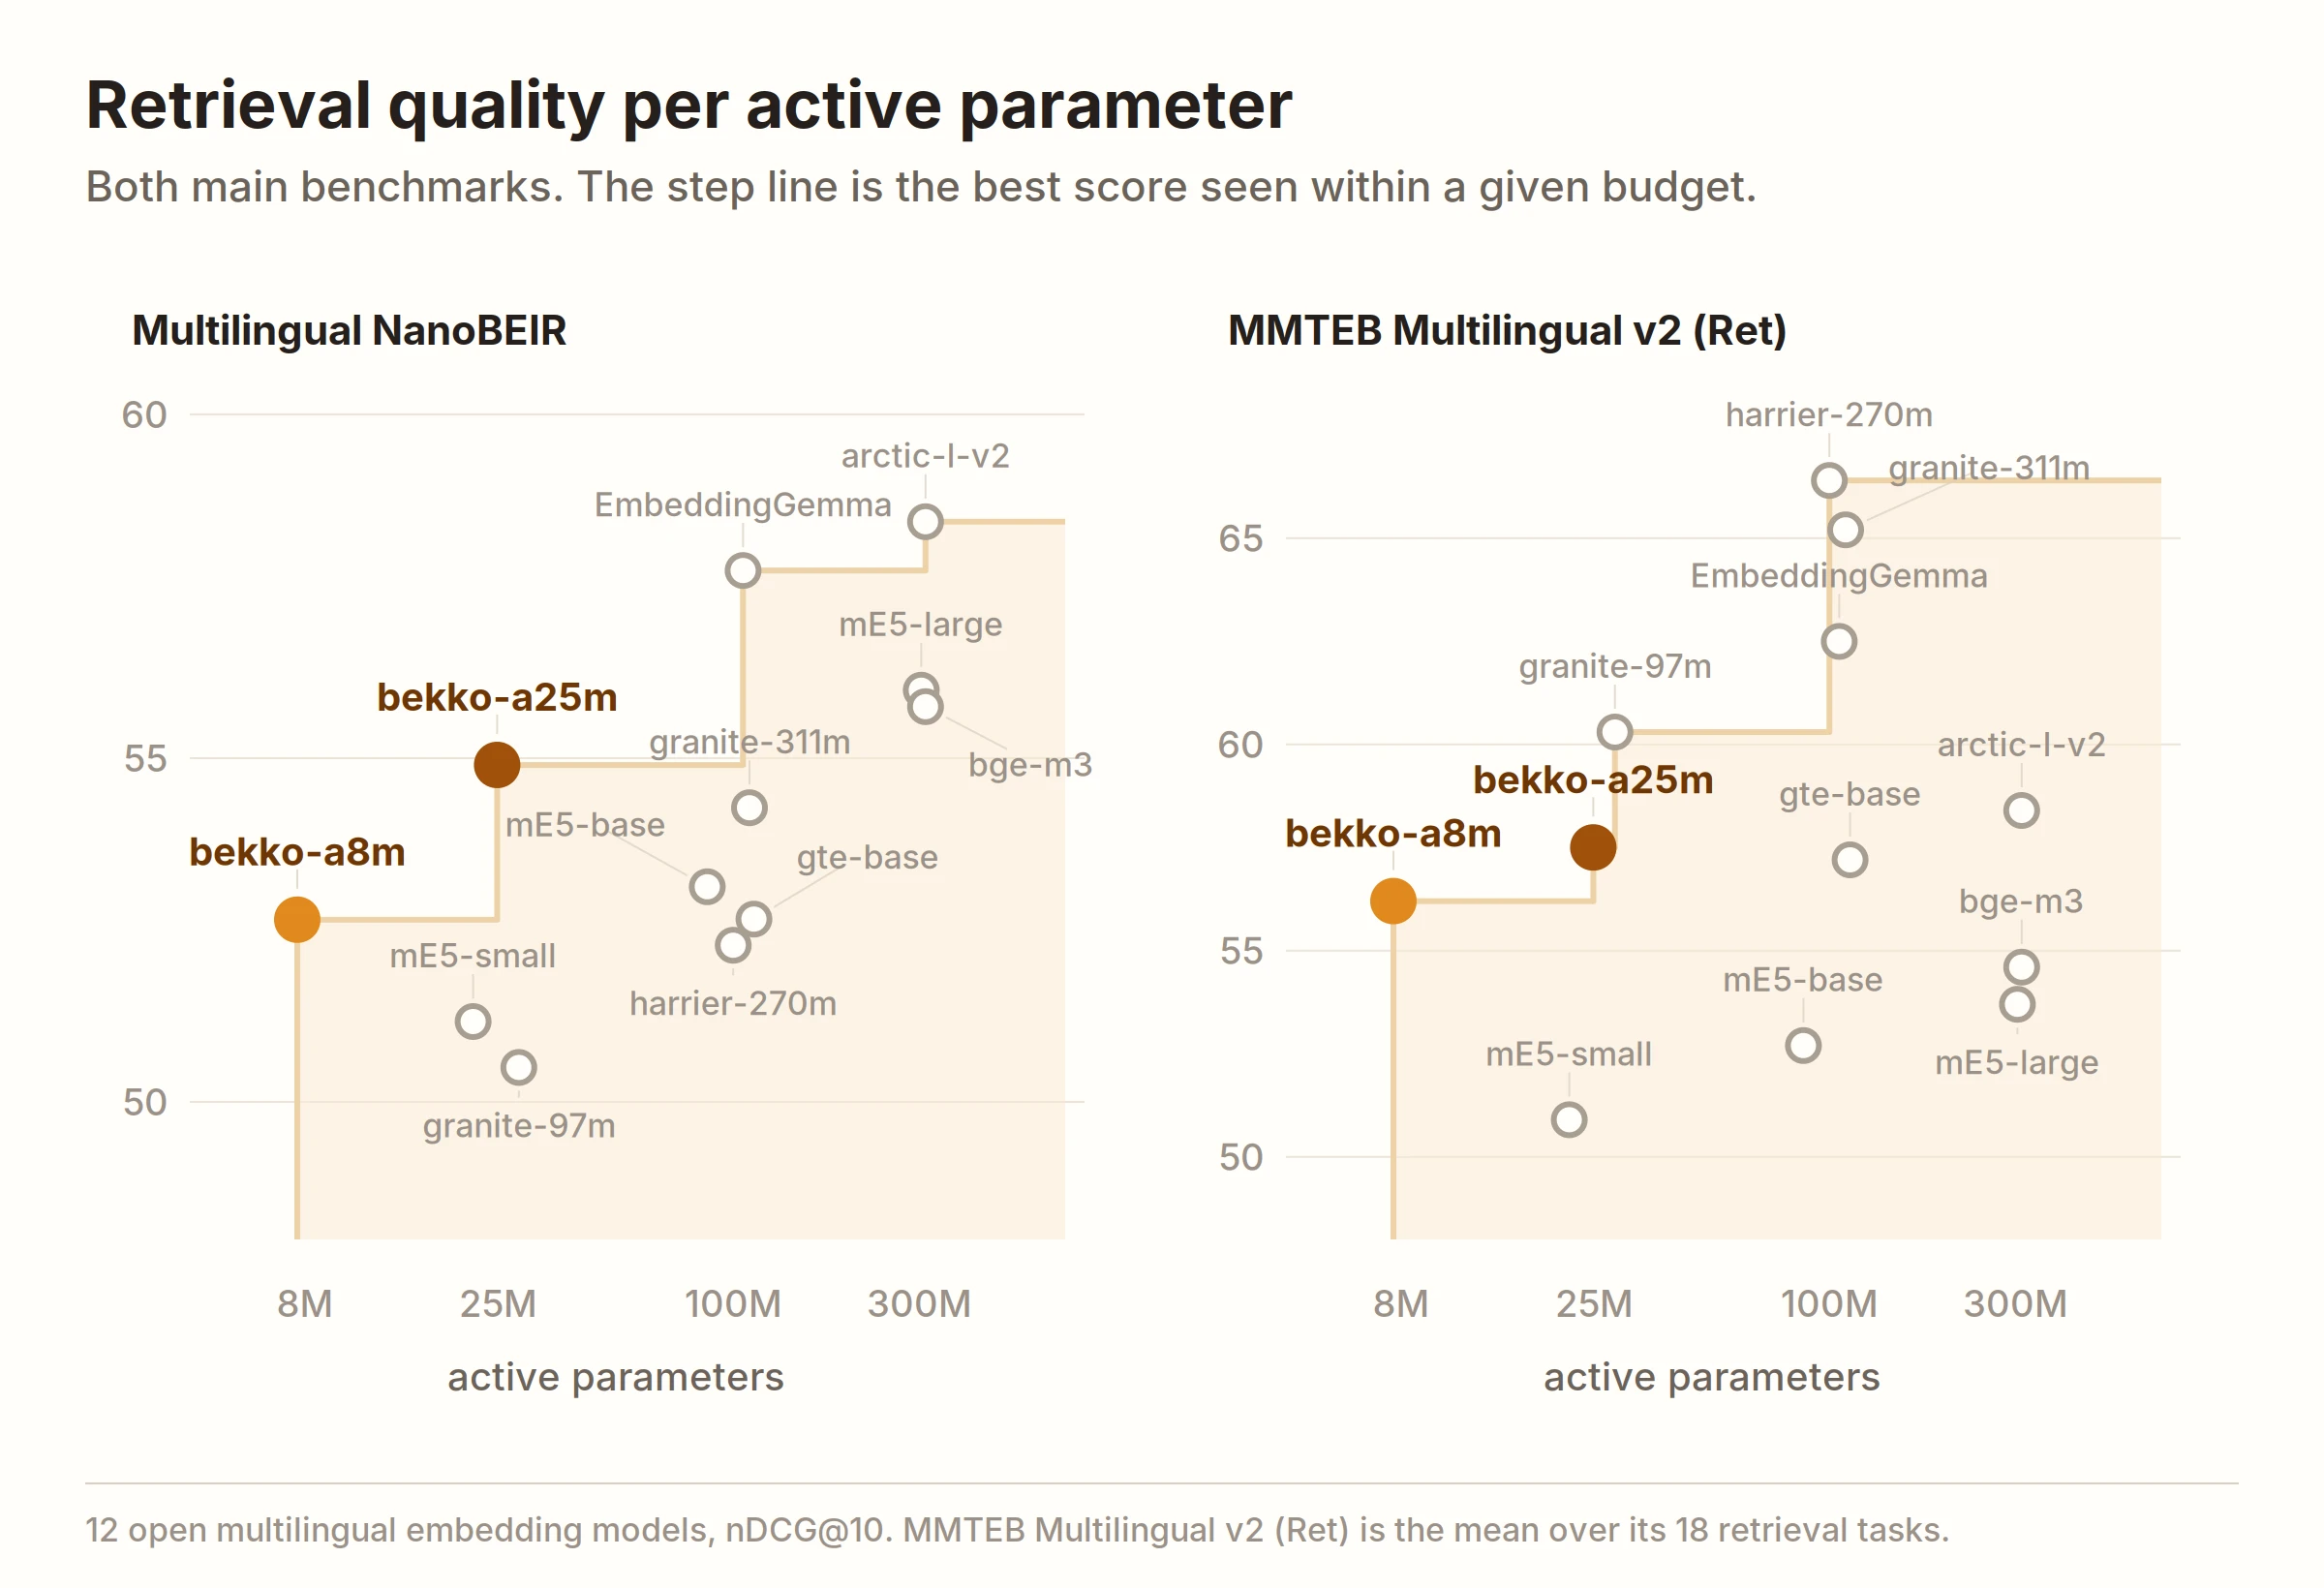
MMTEB の Retrieval では、Transformer の層を1つも動かさずに、multilingual-e5-small との差が約1ポイント(49.96と50.9)でした。 Nano dataset の検索や MMTEB 全体の平均ではまだ multilingual-e5-small の方が高く、MMTEB 平均の差の多くは BitextMining、Reranking、STS によるものです。
小さな Transformer を動かせる環境なら、自分が公開している bekko-embedding-v1-a8m は、アクティブパラメータ770万で表のすべての列で multilingual-e5-small を上回り、CPU でも動きます。 また検索では BM25 も強力なベースラインなので、後半で詳しく比較します。
自分は bekko-static-embedding-v1 の作者で、評価に使った HAKARI-Bench の開発者でもあります。
Static Embedding の仕組み
静的埋め込み(Static Embedding) は、文章を tokenizer でトークンに分け、トークンごとに決まったベクトルを割り当てるモデルです。 文章のベクトル化は、表から各トークンのベクトルを引いて平均を取るだけです。 Transformer の層を通す計算がないので、ベクトルを高速に作れます。
Sentence Transformers での使い方
モデルは Sentence Transformers からそのまま読み込めます。 次の例では、「寿司はおいしい」を英語、フランス語、スペイン語、中国語でベクトル化しています。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("hotchpotch/bekko-static-embedding-v1", device="cpu")
vectors = model.encode(
    [
        "Sushi is delicious.",
        "Les sushis sont délicieux.",
        "El sushi es delicioso.",
        "寿司很好吃。",
    ],
    normalize_embeddings=True,
)
print(vectors.shape)  # (4, 1024)
print(model.similarity(vectors, vectors))クエリと文書は同じ方法でベクトル化でき、query: や passage: のような接頭辞は不要です。
短いベクトルを使いたいときは、truncate_dim(32、64、128、256、512、1024)を指定します。
compact = model.encode(["A short query"], truncate_dim=512, normalize_embeddings=True)MMTEB での評価
多言語での埋め込み性能を測る MMTEB(Massive Multilingual Text Embedding Benchmark) は、検索、文章分類、クラスタリング、文同士の意味的な近さを測る STS(Semantic Textual Similarity) などを含むベンチマークです。
今回は、その中の MTEB(Multilingual, v2) に含まれる131タスクで、出力を切り詰めない1024次元を評価しました。
比較対象は、Sentence Transformers の static-similarity-mrl-multilingual-v1 と、Model2Vec 系の potion-multilingual-128M です。 比較モデルは公開されている評価結果を使い、同じ131タスクで平均を取りました。
| カテゴリ | タスク数 | bekko-static-embedding-v1 | static-similarity-mrl-multilingual-v1 | potion-multilingual-128M | 差 |
|---|---|---|---|---|---|
| 全タスク | 131 | 50.18 | 47.24 | 47.23 | +2.93 |
| Classification | 43 | 52.40 | 48.60 | 52.36 | +3.81 |
| Clustering | 16 | 40.03 | 30.67 | 37.63 | +9.36 |
| MultilabelClassification | 5 | 14.99 | 14.74 | 15.95 | +0.25 |
| Retrieval | 18 | 49.96 | 41.21 | 37.86 | +8.75 |
| Reranking | 6 | 51.59 | 49.45 | 47.39 | +2.14 |
| STS | 16 | 64.50 | 64.02 | 61.23 | +0.47 |
| BitextMining | 13 | 43.68 | 50.62 | 40.72 | -6.94 |
| PairClassification | 11 | 72.81 | 74.34 | 71.39 | -1.53 |
| InstructionReranking | 3 | -1.65 | -1.24 | -2.08 | -0.41 |
表3:MMTEB の各タスクの主指標 × 100 を、カテゴリごとに平均した値です。 「差」は bekko-static-embedding-v1 − static-similarity-mrl-multilingual-v1 です。
全タスク平均は bekko-static-embedding-v1 が50.18で、static-similarity-mrl-multilingual-v1 の47.24、potion-multilingual-128M の47.23を約3ポイント上回りました。
比較した2モデルとの差がそろって大きいのは Retrieval です。 bekko-static-embedding-v1 は49.96で、static-similarity-mrl-multilingual-v1 を8.75ポイント、potion-multilingual-128M を12.10ポイント上回っています。 多言語の検索は、このモデルの強みです。
static-similarity-mrl-multilingual-v1 に対しては、9カテゴリ中6カテゴリで上回りました。 カテゴリ別の差が最も大きいのは Clustering の+9.36ポイントで、STS は+0.47ポイントとほぼ同等です。
一方、対訳文を探す BitextMining、文のペアを分類する PairClassification、指示付きの InstructionReranking では、static-similarity-mrl-multilingual-v1 の方が高くなりました。 特に BitextMining は43.68と50.62で、6.94ポイントの差があります。 対訳文の抽出や文ペアの分類が主な用途なら、static-similarity-mrl-multilingual-v1 も並べて試すとよいでしょう。
HAKARI-Bench による英語検索の評価
検索性能は、HAKARI-Bench の Nano dataset で評価しました。 Nano dataset は、既存の検索ベンチマークを小さくした評価セットです。 以下の HAKARI-Bench の表は、nDCG@10 を100倍し、各タスクを等しい重みで平均した値です。
英語検索には、13タスクと合計649クエリからなる NanoBEIR-en を使いました。 比較する静的モデルは、英語検索用の static-retrieval-mrl-en-v1 と SST-v2 です。 文脈を使う multilingual-e5-small と、自分が公開している文脈ありの小型モデル bekko-embedding-v1-a8m、単語の一致や出現頻度から順位を付ける BM25 も、検索方式を選ぶための参考として並べます。
| モデル | 方式 | 出力次元 | NanoBEIR-en |
|---|---|---|---|
| bekko-static-embedding-v1 | 静的、多言語 | 1024 | 53.71 |
| bekko-static-embedding-v1 | 静的、多言語 | 512 | 52.82 |
| static-retrieval-mrl-en-v1 | 静的、英語検索 | 1024 | 50.35 |
| SST-v2 | 静的、英語検索 | 512 | 51.57 |
| potion-multilingual-128M | 静的、多言語 | 256 | 37.07 |
| multilingual-e5-small | 文脈あり、多言語 | 384 | 58.37 |
| bekko-embedding-v1-a8m | 文脈あり、多言語 | 384 | 60.34 |
| BM25 | 単語ベース | sparse | 57.15 |
表4:NanoBEIR-en のタスク平均。 bekko-static-embedding-v1 は1024次元と512次元、比較する埋め込みモデルは各モデルの標準出力次元です。
bekko-static-embedding-v1 の1024次元は53.71で、英語検索用の SST-v2(51.57)と static-retrieval-mrl-en-v1(50.35)を上回りました。 512次元でも、同じ出力次元の SST-v2 より1.25ポイント高く、13タスク中10タスクで上回っています。
ただし埋め込み表の大きさは異なり、bekko-static-embedding-v1 の約2.05億パラメータに対して、SST-v2 は約1,560万パラメータです。
英語検索だけで見れば、bekko-embedding-v1-a8m(60.34)、multilingual-e5-small(58.37)、BM25(57.15)の方が高いスコアで、Static Embedding との差はまだ残っています。
多言語検索と BM25 の比較
多言語検索では、static-similarity-mrl-multilingual-v1、potion-multilingual-128M、multilingual-e5-small、bekko-embedding-v1-a8m、BM25 と比較しました。 MNanoBEIR は14言語×13タスクの計182件です。 HAKARI-Bench ではこのほかにコード検索、長文検索、日本語検索なども含めた37ベンチマーク、550タスクを評価しており、ここではそのうち10ベンチマークを示します。
| ベンチマーク | タスク数 | bekko-static-embedding-v1(1024次元) | bekko-static-embedding-v1(512次元) | static-similarity-mrl-multilingual-v1 | potion-multilingual-128M | multilingual-e5-small | bekko-embedding-v1-a8m | BM25 |
|---|---|---|---|---|---|---|---|---|
| MNanoBEIR | 182 | 43.76 | 42.89 | 32.29 | 32.23 | 51.17 | 52.65 | 46.46 |
| NanoMMTEB-v2 | 18 | 43.30 | 42.87 | 36.08 | 35.22 | 44.55 | 50.25 | 45.50 |
| NanoMIRACL | 18 | 68.03 | 67.67 | 45.37 | 47.79 | 78.71 | 75.57 | 57.15 |
| NanoRTEB | 14 | 37.50 | 36.53 | 25.73 | 25.58 | 47.11 | 54.98 | 35.53 |
| NanoCoIR | 10 | 58.19 | 57.55 | 48.01 | 45.38 | 69.15 | 74.68 | 54.36 |
| NanoBRIGHT | 20 | 26.38 | 26.31 | 20.27 | 19.67 | 17.58 | 31.49 | 27.90 |
| NanoMLDR | 13 | 55.72 | 54.55 | 35.96 | 34.89 | 39.20 | 54.48 | 73.96 |
| NanoLongEmbed | 6 | 61.96 | 60.58 | 48.90 | 43.90 | 50.14 | 68.19 | 82.17 |
| NanoJMTEB-v2 | 11 | 65.36 | 64.40 | 51.37 | 51.61 | 71.65 | 75.93 | 74.65 |
| NanoIndicQA | 11 | 35.35 | 35.23 | 34.91 | 53.69 | 70.09 | 65.12 | 56.53 |
表5:各ベンチマーク内のタスク平均、nDCG@10 × 100。 static-similarity-mrl-multilingual-v1 は1024次元、potion-multilingual-128M は256次元、multilingual-e5-small と bekko-embedding-v1-a8m は384次元です。 NanoMMTEB-v2 は HAKARI-Bench の検索用セットで、前述の分類なども含む MMTEB とは別の評価です。
static-similarity-mrl-multilingual-v1 に対して、bekko-static-embedding-v1 の1024次元は37ベンチマークすべての平均で上回りました。 タスク単位でも、550件中523件で上回り、27件で下回っています。
potion-multilingual-128M に対しては、37ベンチマーク中36の平均で上回り、タスク単位では550件中520件で上回りました。 例外は NanoIndicQA で、potion-multilingual-128M が53.69、bekko-static-embedding-v1 が35.35でした。
一方、文脈を使うモデルとの差はまだ残っています。 multilingual-e5-small は37ベンチマーク中28、bekko-embedding-v1-a8m は36の平均で bekko-static-embedding-v1 を上回り、MNanoBEIR ではそれぞれ51.17と52.65です。
長文検索の NanoMLDR と NanoLongEmbed では multilingual-e5-small を上回りましたが、これには multilingual-e5-small の入力上限が512トークンであることも影響しています。 入力上限が8192トークンの bekko-embedding-v1-a8m と比べると、NanoLongEmbed では bekko-embedding-v1-a8m が68.19と高く、NanoMLDR では bekko-static-embedding-v1 が55.72と54.48でわずかに上回りました。
検索に Static Embedding を使うべきか
検索だけが目的なら、BM25 で十分なことも多いでしょう。 今回の評価でも、BM25 は37ベンチマーク中21の平均で bekko-static-embedding-v1 を上回り、タスク単位では550件中342件で上回りました。 長文検索の NanoMLDR と NanoLongEmbed、日本語の NanoJMTEB-v2 では、BM25 が大きく上回っています。
一方、自然言語の質問から文書を探す NanoMIRACL では、bekko-static-embedding-v1 が68.03、BM25 が57.15で、Static Embedding の方が10.88ポイント高くなりました。 検索タスクによっては、Static Embedding の方が適しています。
BM25 は単語の一致で文書を探すため、質問と文書で言い回しが異なる場合には埋め込み検索が役立ちます。 どちらが適しているかは、実際の検索対象で両方を試してみるのが確実です。
マトリョーシカ次元と INT8 の選択
1024、512、256、128、64、32次元は、Matryoshka Representation Learning(MRL) でまとめて学習しました。 MRL は、ベクトルの先頭側に有用な情報を集め、先頭の一部だけを取り出しても使えるようにする学習方法です。 用途に合わせてベクトルの長さを選び、保存容量や検索時の計算量を減らせます。
重みの保存精度は、FP16 に加えて INT8 も用意しています。 ここでの INT8 はモデルの重みを8 bit整数にしたもので、出力ベクトルを整数にする操作とは別です。
| 次元 | NanoBEIR-en FP16 | NanoBEIR-en INT8 | MNanoBEIR FP16 | MNanoBEIR INT8 | Overall FP16 | Overall INT8 |
|---|---|---|---|---|---|---|
| 1024 | 53.71 | 53.70 | 43.76 | 43.77 | 45.88 | 45.89 |
| 512 | 52.82 | 52.79 | 42.89 | 42.88 | 45.03 | 45.02 |
| 256 | 50.83 | 50.82 | 41.04 | 41.03 | 43.29 | 43.28 |
| 128 | 47.83 | 47.97 | 38.03 | 38.04 | 40.12 | 40.12 |
| 64 | 43.96 | 44.04 | 32.87 | 32.87 | 34.82 | 34.81 |
| 32 | 35.74 | 35.72 | 24.97 | 24.96 | 26.46 | 26.44 |
表6:マトリョーシカ次元と重みの保存精度による検索スコア。 Overall は550タスク平均で、すべて nDCG@10 × 100です。 INT8 は ONNX の結果です。
1024次元から512次元にすると、ベクトルの長さは半分になり、検索スコアの低下は NanoBEIR-en と MNanoBEIR のどちらも約0.9ポイントでした。 256次元では、低下が2.88と2.72ポイントに広がります。 それでも MNanoBEIR では、128次元の38.03が1024次元の static-similarity-mrl-multilingual-v1(32.29)を上回ります。 INT8 と FP16 の差は、どの次元でも0.15ポイント未満でした。
自分なら、まず512次元から試し、メモリを抑えたいときは INT8 の512次元か256次元を選びます。
使う次元の重みだけを読み込む
Sentence Transformers の truncate_dim は出力ベクトルを切り詰めますが、読み込むのは全1024次元分の表です。
512次元や256次元しか使わないなら、そのぶんのメモリは無駄になります。
そこで、1つの次元の重みだけを持つ ONNX と OpenVINO のファイルもリポジトリに置いています。
モデルカードには、形式、次元数、保存精度を選んで読み込む小さな get_model() ヘルパーを載せています。
from transformers.dynamic_module_utils import get_class_from_dynamic_module

def get_model(backend="onnx", dim=512, precision="int8", revision="main"):
    repo = "hotchpotch/bekko-static-embedding-v1"
    ext = {"onnx": "onnx", "openvino": "xml"}[backend]
    return get_class_from_dynamic_module(
        "bekko_static_backend.BekkoStaticBackend", repo, revision=revision,
    ).load_sentence_transformer(
        repo, revision=revision, backend=backend,
        file_name=f"{backend}/model_{precision}_dim{dim}.{ext}",
    )

model = get_model(backend="onnx", dim=512, precision="int8")| 次元 | FP16 重み | INT8 重み |
|---|---|---|
| 1024 | 409.6 MB | 205.6 MB |
| 512 | 204.8 MB | 103.2 MB |
| 256 | 102.4 MB | 52.0 MB |
| 128 | 51.2 MB | 26.4 MB |
| 64 | 25.6 MB | 13.6 MB |
| 32 | 12.8 MB | 7.2 MB |
表7:次元別に配布するモデルファイルのサイズ(10進の MB)。 ONNX と OpenVINO は同じサイズで、tokenizer(約5.1 MB)は含みません。
たとえば INT8 の512次元は103.2 MBで、FP16 の1024次元(409.6 MB)の約4分の1です。 256次元なら52.0 MBまで小さくなります。
どのモデルを選ぶか
今回の結果から、自分なら次のように選びます。
- 多言語の埋め込みを軽い計算で作りたい場合は、bekko-static-embedding-v1 の512次元から試す。
- 検索だけが目的なら、対象言語に合った BM25 と並べて比較する。
- 対訳文の抽出や文ペアの分類が中心なら、static-similarity-mrl-multilingual-v1 も比較する。
- 検索精度を優先し、Transformer の計算を許容できるなら、multilingual-e5-small や bekko-embedding も候補に入れる。
bekko-embedding は、bekko-static-embedding-v1 とは異なり、Transformer の attention で文脈を扱う埋め込みモデルです。 Transformer 部分の重みを小さくしており、たとえば bekko-embedding-v1-a8m は約770万のアクティブパラメータで、CPU でも推論できます。 今回の比較でも、bekko-embedding-v1-a8m は NanoBEIR-en が60.34、MNanoBEIR が52.65で、どちらも multilingual-e5-small より高いスコアでした。 検索性能と推論速度のバランスを重視したい場合は、bekko-embedding も検討するとよいでしょう。
学習の方法
独自 tokenizer の設計と比較
Static Embedding では、tokenizer が作る単位が、そのまま平均するベクトルの単位になります。
そこで、多言語 BERT や Gemma 2 の既存語彙に加えて、学習データに合わせた語彙を試しました。
多言語の静的モデル static-similarity-mrl-multilingual-v1 が使う bert-base-multilingual-uncased も比較対象にしています。
独自語彙の学習には、単語をさらに小さな断片に分けられる WordPiece を使いました。 まず、Wikipedia と FineWeb から同数ずつ文書を取り、英語の3万語彙を学習します。 次に、英語のトークンIDを保ったまま39言語分の語彙を追加し、全体を20万語彙にしました。
語彙の選択には、学習データの10%を使って各 tokenizer で学習した8モデルを比較しました。 評価は、多言語検索の MNanoBEIR(14言語×13タスク)と NanoMIRACL(18言語)の計200件です。 nDCG@10 を100倍し、200件を等しい重みで平均しています。
表の「uncased」は大文字と小文字を区別しない設定、「cased」は区別する設定です。 「script-balanced」は、文字体系ごとの偏りを調整した候補を指します。 語彙数の「k」は千を表し、たとえば「200k、英語30k」は全20万語彙のうち英語3万語彙を先に確保した構成です。
| tokenizer | 1024次元 | 512次元 |
|---|---|---|
| 多言語 BERT uncased | 37.87 | 37.17 |
| 多言語 BERT cased | 38.51 | 38.01 |
| Gemma 2 | 38.73 | 38.08 |
| 独自100k、英語24k、uncased | 40.19 | 39.29 |
| 独自100k、英語30k、uncased | 39.86 | 39.21 |
| 独自200k、英語30k、cased | 41.60 | 40.69 |
| 独自200k、英語30k、script-balanced | 41.20 | 40.40 |
| 独自200k、英語30k、uncased(採用) | 41.89 | 41.18 |
表8:tokenizer 別の検索スコア、nDCG@10 × 100。 8モデルは同じデータと学習設定で比較しました。 この10%実験では正式版とは異なる対照学習の損失を使っており、正式版モデルのスコアとは直接比較できません。
最も高かったのは、20万語彙、英語3万語彙の uncased 版でした。 1024次元の41.89は、多言語 BERT uncased の37.87、Gemma 2 の38.73を上回ります。 この結果から、正式版にも同じ tokenizer を採用しました。
学習データとハイパーパラメータ
モデルの学習には、bekko-embedding の unsupervised データセット を使いました。 元のデータは、Bekko Embedding 論文で説明した多言語データです。
そのうち40言語を対象とする265のデータ構成から、約8.1億件のテキストペアを学習に使いました。
対象の40言語は、英語、アラビア語、ブルガリア語、ベンガル語、カタルーニャ語、チェコ語、デンマーク語、ドイツ語、ギリシャ語、スペイン語、エストニア語、ペルシア語、フィンランド語、フランス語、ヘブライ語、ヒンディー語、クロアチア語、ハンガリー語、インドネシア語、イタリア語、日本語、韓国語、オランダ語、ノルウェー語、ポーランド語、ポルトガル語、ルーマニア語、ロシア語、スロバキア語、スロベニア語、セルビア語、スウェーデン語、スワヒリ語、テルグ語、タイ語、トルコ語、ウクライナ語、ベトナム語、ヨルバ語、中国語です。
学習する組には、文書のタイトルと本文、質問と回答、検索向けに生成したクエリ、対訳ペアなどが含まれます。 対訳データは NLLB English HQ を残し、ほかの対訳系列を選択から外しました。 MIRACL の train split や NLI に由来するデータも含みます。
埋め込み表はランダムに初期化し、対応するテキストの組が近くなるように学習します。 損失には、同じバッチ内のほかの候補と区別する Multiple Negatives Ranking Loss(MNRL) を使い、全1024次元と各マトリョーシカ次元に適用しました。 教師モデルの出力ベクトルを模倣する蒸留は行っていません。
| 設定 | 値 |
|---|---|
| モデル | ランダム初期化した静的埋め込み表と平均プーリング |
| 語彙数、埋め込み次元 | 200,000、1,024 |
| 埋め込み表のパラメータ数 | 204,800,000 |
| データ | 40言語を対象とする265構成、約8.14億行 |
| 損失 | MNRL、温度0.03(scale = 1 / 0.03) |
| MRL 次元 | 32、64、128、256、512、1,024 |
| MRL の重み | 0.025、0.05、0.1、0.15、0.3、1.0(上の次元順) |
| エポック、更新回数 | 1、49,727 |
| グローバルバッチサイズ | 16,384 |
| 学習率 | 0.25 |
| スケジュール | 10% warmup と cosine decay |
| 最適化 | AdamW、weight decay 0、β₂ = 0.999、ε = 1e−8 |
| 学習精度 | BF16 mixed precision、学習後のマスター重みは FP32 |
| 学習時の入力上限 | 512トークン |
| seed | 42 |
| データの取り出し | 構成ごとの件数に比例したサンプリング、バッチ内の重複を抑制 |
表9:正式モデルの学習設定。
再現用スクリプト
モデルのリポジトリには、tokenizer 学習、モデル学習、FP16 書き出しのスクリプト を置いています。 学習設定とデータの選択設定も含めているので、データの選択から FP16 での書き出しまでを追えます。
HAKARI-Bench の結果
HAKARI-Bench の結果は、leaderboard で確認できます。
リンク先では、multilingual-e5-small、bekko-embedding-v1-a8m と、名前に static を含むモデルを比較できます。
参考文献と関連実装
- Yuichi Tateno, Bekko Embedding: Parameter-Efficient Multilingual Retrieval with Ultra-Compact Encoders, 2026。 学習データの背景となる、文脈付き Bekko Embedding の論文。
- Yuichi Tateno, HAKARI-Bench: A Lightweight Benchmark for Comparing Retrieval Architectures and Efficiency Settings under Unified Conditions, 2026。 検索方式や次元削減を比較する軽量評価の設計。
- Kenneth Enevoldsen et al., MMTEB: Massive Multilingual Text Embedding Benchmark, 2025。 多言語の分類、類似度、検索などを評価するベンチマーク。
- Aditya Kusupati et al., Matryoshka Representation Learning, 2022。 先頭の一部の次元でも使える表現を学習する方法。
- Nandan Thakur et al., BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models, 2021。 異なる検索タスクと検索方式の比較。
- Xinyu Zhang et al., Making a MIRACL: Multilingual Information Retrieval Across a Continuum of Languages, 2023。 18言語の自然言語質問と関連文書の評価データ。
- Stephan Tulkens and Thomas van Dongen, Model2Vec: Fast State-of-the-Art Static Embeddings, 2024。 Sentence Transformer から静的埋め込みを作るソフトウェアと技術解説。
- Minish Lab, potion-multilingual-128M。 Model2Vec 系の多言語モデルと学習方法。
- Tom Aarsen, Train 400x faster Static Embedding Models with Sentence Transformers。 静的モデルの学習方法と既存2モデルの解説。
- RikkaBotan, Stable Static Embedding 技術レポートとSSE Retrieval MRL v2 技術レポート。 静的な英語検索モデルの設計と評価。